StackSaga Cassandra 响应式支持 (Reactive Support)
stacksaga-cassandra-reactive-support 是 StackSaga 引擎的响应式(非阻塞,Reactive)Cassandra 适配器,提供 StackSaga 事件存储 (Event Store) 的 Cassandra 实现。
它处理了每个分布式事务系统都必须解决的两个核心问题:
-
事件存储 (Event Store) —— 持久化每个 Saga 的事务状态、执行尝试历史 (Execution Tryout History) 和幂等性标记。
-
恢复引擎 (Recovery Engine) —— 一个自治的、无墓碑 (Tombstone-Free) 的 5 层目录架构,可自动恢复遇到瞬时网络故障的事务(重试,Retry)或因服务器异常崩溃而遗留的事务(还原,Restore),无需开发人员手动干预。
本指南全面涵盖这两个核心主题,从环境搭建步骤开始,深入探讨数据库模式 (Schema)、写入保护机制以及恢复引擎内部架构。
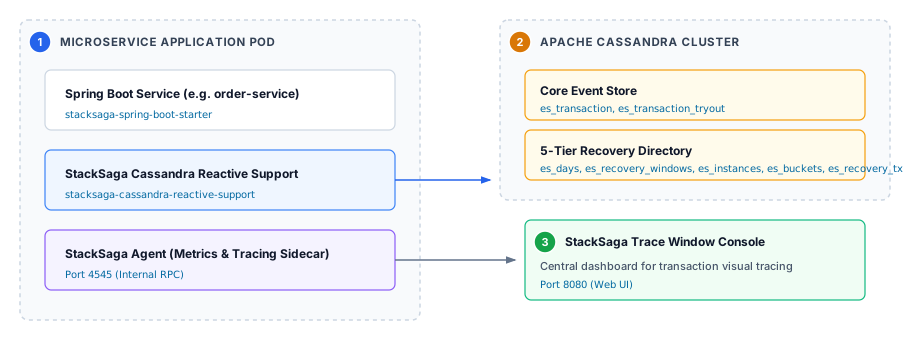
系统跨越三个相互连接的环境运行:
-
微服务应用程序 Pod (Microservice Application Pod): 运行中的 Spring Boot 微服务(例如
order-service),集成了stacksaga-spring-boot-starter与stacksaga-cassandra-reactive-support。 -
Apache Cassandra 集群 (Cluster): 分布式数据层,同时存储核心事件存储表(
es_transaction、es_transaction_tryout)和 5 层恢复目录表。 -
StackSaga Trace Window: 集中式 Web 可观测性控制台,通过 StackSaga Agent 边车 (Sidecar) 连接,用于实时可视化 Saga 执行状态(参见 StackSaga TraceWindow 链路追踪控制台 (Dashboard))。
|
重试顺序保证(Murmur3 令牌顺序与严格 FIFO,Murmur3 Token Order vs. Strict FIFO): 在单个 1 分钟的重试窗口内,重试节点(Worker)按令牌顺序(通过 Murmur3 令牌范围切片)发现待重试事务,而不是按照失败发生的精确毫秒顺序。 在不同的分钟窗口和日历天之间,重试处理是严格按时间顺序 (Chronological) 进行的(较早的分钟窗口和日历日期始终优先遍历)。 严格顺序 FIFO 要求的架构建议: |
第 1 部分:环境搭建 (Setup)
为您的编排器应用程序添加 Cassandra 支持包含 3 个步骤:
步骤 1:添加依赖项 (Add the Dependency)
将该库添加到编排器项目的 pom.xml 中:
stacksaga-cassandra-reactive-support 依赖项<dependencyManagement>
<dependencies>
<dependency>
<groupId>org.stacksaga</groupId>
<artifactId>stacksaga-bom</artifactId>
<version>1.0.0-SNAPSHOT</version>
<type>pom</type>
<scope>import</scope>
</dependency>
</dependencies>
</dependencyManagement>
<dependency>
<groupId>org.stacksaga</groupId>
<artifactId>stacksaga-cassandra-reactive-support</artifactId>
</dependency>| 您还可以使用 StackSaga Initializer 生成预先配置好依赖项的项目骨架。 |
步骤 2:创建键空间与数据库模式 (Create the Keyspace and Schema)
StackSaga 在所有服务和环境中共享一个键空间 (Keyspace) 并使用静态表名。
多租户、服务作用域、区域边界和虚拟集群通过复合分区键(PRIMARY KEY region, cluster, service_name, …)实现隔离,无需为每个服务动态生成表。
1. 创建键空间 (Keyspace)
对于生产环境部署,请始终使用配置了本地数据中心名称和副本因子的 NetworkTopologyStrategy:
CREATE KEYSPACE IF NOT EXISTS stacksaga_event_store
WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'datacenter1': 3
}
AND durable_writes = true;
对于本地开发或隔离测试,您可以使用 'class': 'SimpleStrategy', 'replication_factor': 1。
|
2. 执行统一模式脚本 (Executing the Unified Schema Script)
统一模式脚本创建 9 张静态表,划分为两个协调工作组:
| 工作组 | 表名 | 用途 |
|---|---|---|
核心事件存储 (Core Event Store) (4 张表) |
|
主事务状态与元数据存储(单行分区,Single-Row Partition)。 |
|
事务步骤执行历史,按事务 ID 物理共存 (Physically Co-located)。 |
|
|
隔离表,存储补偿(回滚)发生不可逆故障的异常事务。 |
|
|
步骤执行标记与幂等性租约表,用于事件流去重。 |
|
5 层恢复引擎 (5-Tier Recovery Engine) (5 张表) |
|
第 1 层:包含待重试或待还原任务的活跃日历日期目录。 |
|
第 2 层:每天活跃的 UTC 分钟窗口目录(0 到 1439)。 |
|
|
第 3 层:按 Murmur3 令牌哈希聚类的 Pod 实例标记,用于空间 Worker 切片。 |
|
|
第 4 层:连续桶索引目录(偶数 = 重试 Retry,奇数 = 还原 Restore)。 |
|
|
第 5 层:有界恢复元数据分区(< 50,000 行,约 3–5MB)。 |
步骤 3:配置 Cassandra 连接 (Configure the Cassandra Connection)
stacksaga-cassandra-reactive-support 使用标准的 DataStax Java Driver 配置格式。
在项目的 src/main/resources 目录下创建名为 stacksaga-cassandra.conf 的文件:
src/main/resources/stacksaga-cassandra.confdatastax-java-driver {
basic {
# Cassandra 集群接触点 (host:port)
contact-points = ["127.0.0.1:9042"]
# 创建 StackSaga 表的目标键空间
session-keyspace = "stacksaga_event_store"
load-balancing-policy {
# 匹配您的 Cassandra 集群拓扑的本地数据中心名称
local-datacenter = "datacenter1"
}
# 响应式驱动执行的请求超时时间
request.timeout = 10 seconds
}
advanced {
auth-provider {
# 集群认证的纯文本凭证
class = PlainTextAuthProvider
username = "cassandra"
password = "cassandra"
}
timestamp-generator {
# 使用服务端时间戳与集群时间对齐
class = ServerSideTimestampGenerator
}
reconnection-policy {
# 指数重连策略,实现弹性网络恢复
class = ExponentialReconnectionPolicy
base-delay = 1 second
max-delay = 60 seconds
}
}
}
您可以在 application.yml 中通过 stacksaga.cassandra.config 自定义配置文件路径(例如 stacksaga.cassandra.config: file:/etc/stacksaga/cassandra.conf)。
|
|
为什么默认一致性级别使用 |
第 2 部分:事件存储 (The Event Store)
在深入恢复引擎之前,了解 StackSaga 如何组织和存储实时事务数据非常重要。 这 4 张核心事件存储表独立于恢复引擎运行,绝不会受到轮询队列范围扫描 (Polling-Queue Range Scans) 的影响。
es_transaction —— 主事务记录
每个 Saga 事务在 es_transaction 中恰好有一行,由 transaction_id 作为键。
如果同时创建数千个事务,单个 Cassandra 节点是否会成为热点?
transaction_id 是一个 UUID,Cassandra 的 Murmur3 分区器会将其在无需任何中心协调的情况下均匀分布到所有集群节点。
即使在 100,000 个并发写入的突发峰值下,数据行也会均匀散落在各物理存储节点上,从结构上杜绝了热点的产生:
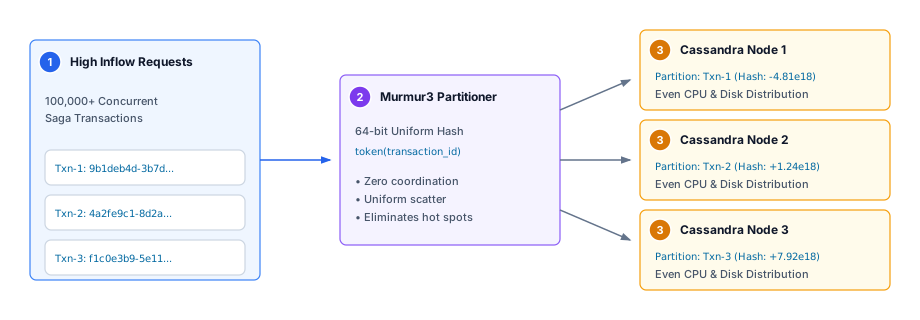
-
高并发请求流入: 跨水平扩展的应用程序节点同时发起超过 100,000 个并发 Saga 事务。
-
Murmur3 分区器: Cassandra 的 64 位 Murmur3 哈希将
transaction_id均匀打散在令牌空间中,零协调且零锁争用。 -
集群均匀散列: 写入均匀落在物理节点上,确保 CPU、内存和磁盘 I/O 保持平衡,无局部热点。
es_transaction_tryout —— 步骤执行历史
每个 Saga 步骤尝试(称为 "tryout")都作为单个数据行存储在相同的 transaction_id 分区键下。
读取事务的执行历史是否需要跨网络触及多个节点?
不需要。
由于 es_transaction 和 es_transaction_tryout 共享完全相同的复合分区键 region, cluster, service_name, transaction_id,Cassandra 会将父事务及其所有步骤尝试放置在完全相同的物理存储节点上:
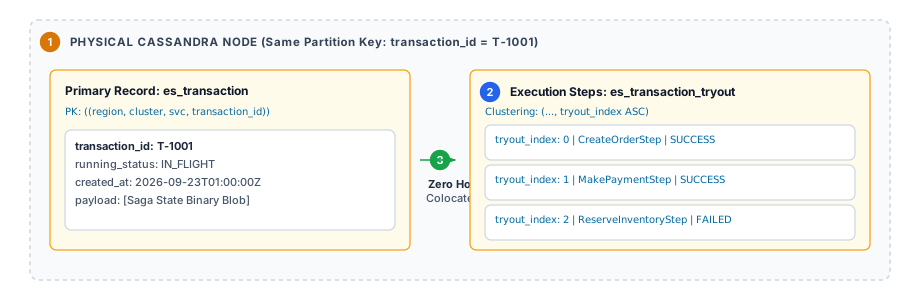
es_transaction_tryout)-
物理 Cassandra 节点共存: 由于
es_transaction和es_transaction_tryout共享完全相同的复合分区键region, cluster, service_name, transaction_id,给定事务的所有记录都位于完全相同的物理节点上。 -
步骤执行聚类行 (Clustering Rows): 单个 Saga 步骤尝试按聚类行顺序(
tryout_index ASC)追加在分区内。 -
零跳跃共存读取 (Zero-Hop Colocated Read): 获取事务及其完整步骤历史始终是单节点的零跳跃本地读取操作,从而最大化性能。
es_frozen_transaction —— 隔离表 (The Quarantine Table)
如果连补偿(回滚)步骤也失败了怎么办?事务会丢失吗?
不会 —— 它会被安全隔离。es_frozen_transaction 存储自动补偿步骤本身遇到不可恢复错误、导致事务处于部分补偿状态的记录。
这些事务被隔离以保护下游系统免受进一步副作用的影响。
它们需要开发人员介入诊断,并通过管理还原端点进行手动重新触发。
es_execution_markers —— 幂等性租约表 (The Idempotency Lease Table)
es_execution_markers 存储步骤执行标记和幂等性租约,防止在 Kafka 消费者组重平衡 (Rebalance) 或网络重复投递期间重复执行 Saga 步骤。
分区生命周期与存储清理:
每个事务的执行标记共享复合分区键 region, cluster, service_name, transaction_id —— 与 es_transaction 和 es_transaction_tryout 相同。
在 Saga 的生命周期中,每个执行的步骤都会向该分区追加一个聚类行 (step_id)。
当事务达到终态(PROCESS_COMPLETED 或 REVERT_COMPLETED)时,引擎会对 es_execution_markers 执行单次分区级删除 (Partition-Level Delete):
DELETE FROM es_execution_markers
WHERE region = :region AND cluster = :cluster
  AND service_name = :service_name AND transaction_id = :transaction_id;
由于该操作直接针对完整复合分区键,Cassandra 会写入单个分区墓碑 (Partition Tombstone) —— 而不是每个步骤标记一个单元格墓碑 (Cell Tombstone)。
在 SSTable 压缩 (Compaction) 期间,无论 Saga 执行了多少个步骤,整个分区(该事务的所有步骤标记)都会在 O(1) 时间内被清理。
这保证了 es_execution_markers 的存储是自收敛的 (Self-Bounded):数据行仅在活动事务窗口期间写入,并在事务结束时完全回收,无需周期性清理作业。
第 3 部分:写入保护(Kafka 事件溯源)
在使用 Kafka 或类似流消息代理进行事件驱动 Saga 编排时,防止重复步骤执行和竞态条件至关重要。
为什么会出现重复事件 (Why Duplicate Events Occur)
StackSaga 的 Kafka 消息层使用*至少一次投递语义 (At-least-once delivery semantics)*。 在分布式环境中,重复事件投递很常见,原因包括:
-
Pod 扩缩容时的消费者组重平衡 (Rebalance)。
-
消费者节点在 Offset 提交确认之前发生重启。
-
网络超时与自动化消息重试。
如果没有保护措施,同一 Saga 步骤可能会执行两次 —— 导致信用卡被重复扣款、重复预留库存或向客户发送多封确认邮件。
STRICT 模式 —— 基于 Cassandra LWT 的互斥
STRICT 模式使用 Cassandra 轻量级事务(基于 Paxos 的 LWT,Lightweight Transactions)在运行任何业务逻辑之前获取独占的临时执行租约:
步骤 1: INSERT INTO es_execution_markers ... IF NOT EXISTS USING TTL <leaseDuration>
         → 如果该行不存在:当前 Pod 获得租约 ([applied] == true)。继续执行。
         → 如果该行已存在 (TTL > 0):另一个 Pod 正在执行。退避并重试。
         → 如果该行已存在 (TTL = 0):已永久提交。安全跳过。

步骤 2: 执行 Saga 步骤业务逻辑。

步骤 3: UPDATE es_execution_markers SET execution_state = 'COMMITTED', TTL = 0
         → 将临时租约转换为永久标记。
         → 所有其他 Pod 现在看到 TTL = 0 并干净终止。
如果 Pod 在步骤 1 和步骤 3 之间崩溃,临时租约将在其 TTL 结束后过期,允许另一个 Pod 重试并干净完成 Saga 步骤。
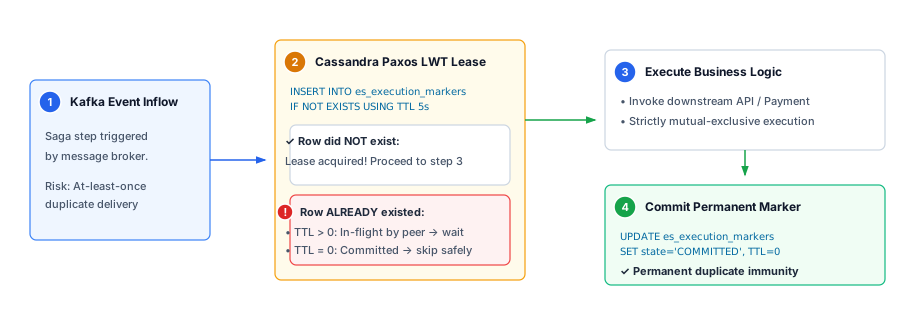
-
Kafka 事件流入: 来自 Kafka 的 Saga 步骤执行事件到达,可能存在至少一次投递导致的重复。
-
Paxos LWT 租约获取: Pod 对
es_execution_markers执行原子的INSERT … IF NOT EXISTS USING TTL 5s。 如果租约存在且TTL > 0,Pod 退避;如果TTL = 0,则直接跳过。 -
互斥执行: 持有活动租约的唯一步骤 Pod 执行 Saga 业务逻辑。
-
永久标记提交: 成功后,将标记提交为
TTL = 0,赋予永久防重免疫能力。
RELAXED_WITH_DEDUP 模式 —— 轻量级读取检查
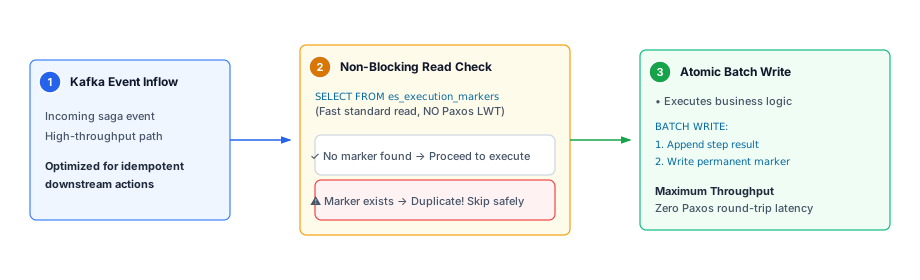
RELAXED_WITH_DEDUP 完全跳过了 Paxos LWT 的网络开销。
在执行之前,引擎对 es_execution_markers 执行快速读取。
如果找到已完成的标记,则跳过执行。
该模式避免了 Cassandra LWT 往返,从而最大化吞吐量。
-
Kafka 事件流入: 在操作天然具有幂等性的高吞吐流式管道上接收事件。
-
非阻塞读取检查: 对
es_execution_markers执行快速读取,无 Paxos 共识开销。 如果标记存在,则立即终止执行。 -
原子批量写入: 步骤结果和执行标记在单个记录批处理中一起提交。
何时使用 RELAXED_WITH_DEDUP:
* 当下游操作天生具有幂等性时(例如设置绝对值、更新缓存、写入审计日志)。
* 当吞吐量至关重要且重复执行不承担业务风险时。
领域级别配置 (Domain-Level Configuration)
写入保护可以进行全局配置,并可按 Saga 领域单独覆盖:
application.ymlstacksaga:
cassandra:
write-protection:
default-mode: RELAXED_WITH_DEDUP # 默认高吞吐模式
default-lease-duration: 5s # 默认 LWT 租约 TTL(适用于 STRICT 模式)
domains:
order-saga:
mode: STRICT # 订单创建采用严格互斥
lease-duration: 10s # 自定义租约 TTL 覆盖
payment-saga:
mode: STRICT # 支付采用 STRICT 模式并使用默认 5s 租约
notification-saga:
mode: RELAXED_WITH_DEDUP # 通知采用高吞吐模式第 4 部分:恢复引擎与 5 层目录架构 (The Recovery Engine & The 5-Tier Directory Architecture)
恢复引擎 (Recovery Engine) 负责确保在发生基础设施中断时,没有任何分布式事务被永久丢失或遗弃。 它提供了两项独立但在架构上统一的能力:
| 功能特性 | 触发时机 | 根本原因 |
|---|---|---|
重试 (Retry) |
Saga 步骤调用下游微服务时收到 HTTP 503、连接超时或瞬时网络错误。 |
下游依赖暂时降级。事务被明确计划为异步重新调用。 |
还原 (Restore) |
Pod 在事务处理中途崩溃(断电、OOM 终止、Kubernetes Pod 强制驱逐)。 |
进程终止时事务正在进行中。任何日志或表中均未记录任何错误。 |
这两项特性共享相同的 5 层 Cassandra 目录结构以及相同的重试节点 (Retry-Node) 池 —— 仅通过偶数桶索引(重试 Retry)与奇数桶索引(还原 Restore)进行区分。
为什么 Cassandra 需要基于目录的架构 (Why Cassandra Requires a Directory-Based Architecture)
在关系型数据库(PostgreSQL、MySQL)中,实现重试队列非常直接:
SELECT * FROM retry_queue
WHERE status = 'PENDING' AND retry_time <= NOW()
ORDER BY retry_time ASC LIMIT 100;
关系型引擎使用 B-Tree 索引在毫秒级内定位待处理数据行,并对其进行就地更新或删除。 但在 Cassandra 中,尝试将单张平面表作为主动轮询队列是一个众所周知的分布式反模式 (Anti-Pattern):
-
队列缺少全局二级索引 (Absence of Global Secondary Indexing for Queues): Cassandra 使用分区键哈希将分区分布在集群节点上。 跨分区之间不存在全局 B-Tree 索引。 在未知精确分区键的情况下轮询平面表需要进行全集群范围扫描(
ALLOW FILTERING),这会导致灾难性的网络 I/O 和查询超时。 -
队列反模式与墓碑扫描 (The Queue Anti-Pattern & Tombstone Scanning): Cassandra 的 SSTable 是不可变的 (Immutable)。 删除数据行会写入一个墓碑 (Tombstone)。 在不断添加和删除任务的轮询队列中,扫描下一个可用任务的查询必须先跳过所有已完成任务的墓碑,然后才能到达有效数据。 如果一次扫描跳过超过 100,000 个墓碑,Cassandra 将直接中止查询并抛出
ReadFailureException。 -
可预测的高性能必须精准指定分区键 (Predictable Performance Requires Partition-Key Targeting): 当查询能够提供精确的复合分区键时,Cassandra 的性能极快。
StackSaga 通过将恢复发现建模为分层活动目录 (Hierarchical Active Directory) 解决了这一问题 —— 这是一个由狭窄索引表组成的树状结构,每一层都指向下一层,因此工作节点始终按精确分区键进行查询,绝不进行盲目的范围扫描。
核心系统角色:分工与职责 (Core System Roles: Who Does What?)
为了理解重试、还原和压缩如何在没有分布式锁的情况下协同运作,区分核心组件至关重要:
| 组件 / 角色 | 概念定义 | 在 Cassandra 中的职责 |
|---|---|---|
标准节点 (Standard-Nodes) |
水平扩展的微服务实例(例如运行 |
写入者 (重试 Retry): 发生瞬时故障时,向前写入到窗口 W+1,递增 JVM 本地偶数 |
重试节点 (Retry-Nodes) |
启用了 StackSaga 重试子系统的专用编排器实例,负责恢复停滞或孤立的事务。 |
读取者与本地压缩者 (Readers & Local Compactors): 从环形协调器获取独占的 Murmur3 令牌租约,仅为其分配的令牌范围扫描已密封的窗口 (⇐ W),重新调用事务,并通过 O(1) 分区删除操作清理已完成的桶分区。 |
RSocket 环形协调器 (RSocket Ring Coordinator) |
伴随微服务部署的独立轻量级集群服务 ( |
令牌租约权威机构 (Token Lease Authority): 将 64 位 Murmur3 令牌环 ( |
Node-0 |
持有环形协调器锚点(最低)令牌租约的重试节点。它既作为普通恢复工作节点运行,又执行集群范围的目录清理剪枝。 |
全局目录压缩者 (Global Directory Compactor): 在从第 2 层删除已完成的分钟窗口以及从第 1 层删除空的日历日期之前,运行两道严格的验证门禁 (Two Verification Gates)。 |
主事件存储 (Primary Event Store) |
永久性事务数据库账本。 |
真相来源 (Source of Truth): 存储完整的 Saga 状态、执行历史和业务载荷。与恢复目录彻底解耦 —— 绝不承受轮询队列范围扫描。 |
|
环形协调器 (Ring Coordinator) 是否是单点故障? |
5 层目录架构概览 (The 5-Tier Directory Architecture at a Glance)
目录结构组织如下:
es_days_by_year                             ← 第 1 层:哪些日历日期存在待处理任务?
  └── es_recovery_windows_by_day            ← 第 2 层:当天的哪些 UTC 分钟窗口?
        └── es_instances_by_recovery_window ← 第 3 层:哪些 Pod 实例在该窗口中写入了任务?
              └── es_buckets_by_instance    ← 第 4 层:该 Pod 创建了哪些桶分区?
                    └── es_recovery_transactions_by_instance ← 第 5 层:实际的事务指针。
工作节点从不扫描空表。
每一层的每个查询都提供其上一层的完整复合分区键,自顶向下遍历目录树,直到发现需要重新调用的 transaction_id 指针。
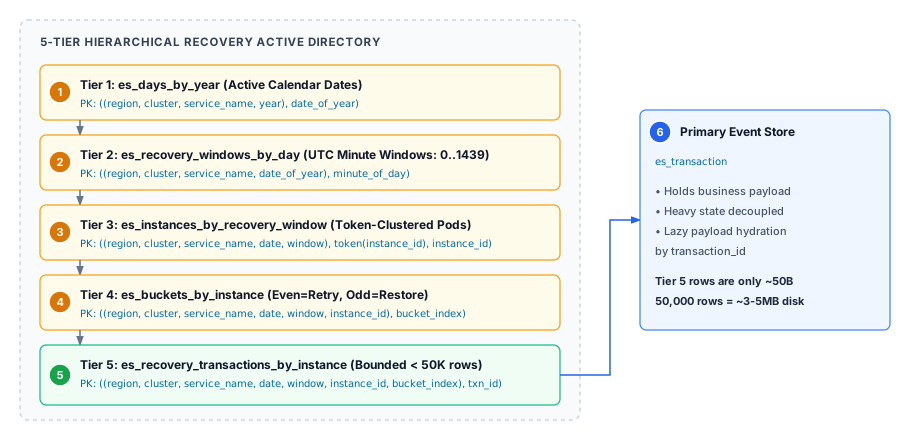
活动目录树通过五个协同层级运作:
-
第 1 层 (
es_days_by_year): 跟踪给定服务哪些日历日期包含待恢复的事务,防止空表扫描。 -
第 2 层 (
es_recovery_windows_by_day): 将每天 24 小时划分为离散的 UTC 分钟窗口(0到1439),按升序时间顺序(minute_of_day ASC)处理。 -
第 3 层 (
es_instances_by_recovery_window): 按 Murmur3 令牌哈希 (token(instance_id)) 聚类的 Pod 实例标记,用于工作节点的空间切片。 -
第 4 层 (
es_buckets_by_instance): 连续桶分配目录(偶数 = 重试 Retry,奇数 = 还原 Restore)。 -
第 5 层 (
es_recovery_transactions_by_instance): 有界恢复元数据分区(< 50,000 行,约 3–5MB),通过单个分区墓碑在 O(1) 时间内清理。 -
主事件存储 (
es_transaction): 解耦的重量级状态存储,按transaction_id进行延迟水合 (Lazy Hydration)。
|
等等 —— 第 3 层存储了标准节点自身的
|
功能特性 1:重试 (Feature 1: Retry)
有界分区:实例级本地分桶 (Bounded Partitions: Instance-Level Local Bucketing)
如果主要下游服务发生宕机,且成千上万个 Pod 同时开始失败,会发生什么?
它们是否会全部写入同一个 Cassandra 分区并突破 100MB 限制?
在高吞吐微服务生态系统中,大规模下游故障可能在数秒内在所有运行中的 Pod 上引发数十万次事务失败。
在 Apache Cassandra 中,保持严格有界的分区(理想情况下低于 50,000 行且 < 100MB)对于防止 JVM 垃圾回收停顿、读取超时和压缩热点至关重要。
StackSaga 通过将 JVM 本地原子计数器 与基于 Murmur3 的自治工作节点再分配 相结合,彻底消除了分布式计数瓶颈。
第 5 层的复合分区键不再跨实例共享全局桶,而是直接整合写入实例的唯一定位标识 (instance_id):
PRIMARY KEY (
  (region, cluster, service_name, date_of_year, minute_of_day, instance_id, bucket_index),
  transaction_id
)
每个运行中的编排器 Pod 都在本地 JVM 内存中独立管理自己的桶计数器,无需任何跨网络协调。
当某个 Pod 的本地计数器达到 50,000 时,只有该特定 Pod 将其 bucket_index 递增到下一个偶数值(0 → 2 → 4)。
所有写入 Pod 都以 O(1) 时间完全并发写入完全隔离的分区中。
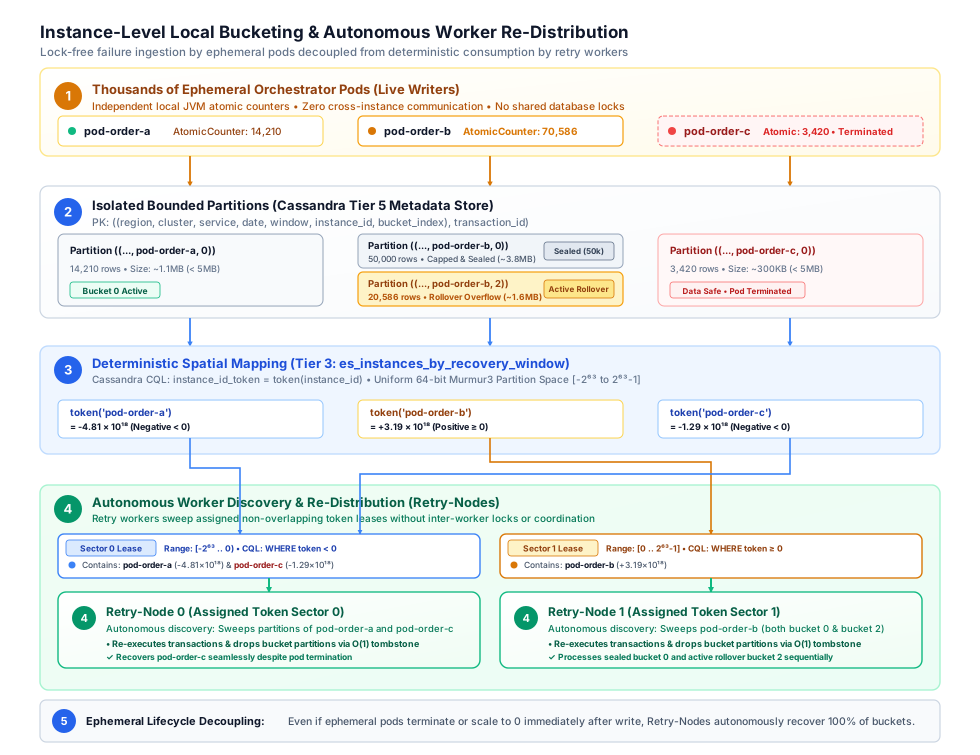
该机制通过五个阶段运作:
-
数千个临时编排器 Pod(实时写入者): 每个实时应用 Pod 在每个写入窗口中维护一个内存中的
AtomicLong计数器。 递增操作耗时约 2 纳秒,无需数据库锁。 -
隔离的有界分区(第 5 层元数据存储): 分区严格限制为最多 50,000 行(磁盘上约 3MB 至 5MB),远低于 Cassandra 的 100MB 阈值。
-
确定性空间映射 (
instance_id_token = token(instance_id)): Pod 在第 3 层注册其令牌哈希,均匀散布在连续的 64 位令牌环(-2^63至2^63 - 1)上。 -
自治工作节点发现与再分配: 重试节点扫描分配的令牌扇区租约,在没有跨工作节点锁的情况下确定性地认领实例,并通过 O(1) 分区墓碑清理已完成的分区。
-
临时生命周期解耦(已终止 Pod 的恢复保证): 实时 Pod 可以在写入故障记录后立即缩容、重启或终止;100% 的待重试任务保证能够被恢复。
|
每次故障都写入 5 张表 —— 这是否会降低实时 API 的速度? 如果标准节点 Pod 在窗口中途中断重启怎么办?其内存中的 AtomicLong 计数器重置为 0 —— 这会覆盖或损坏旧桶吗? 为什么 Saga 事务载荷不会导致第 5 层恢复分区超出 Cassandra 100MB 的分区限制? |
三元窗口同步模型 (The Ternary-Window Synchronization Model)
如何防止重试节点读取标准节点仍在活跃写入的窗口?无感崩溃 (Silent Crash) 恢复又处于什么位置?
事务处理跨越三个互不干扰的时间视界 (Temporal Horizons) 运作,明确划分了标准节点(故障时前向预写并装载守护标记)与重试节点(读取并压缩已密封窗口)之间的职责。
这一严格规则使得读取者与写入者在物理上绝不可能同时触及相同的 Cassandra 分区 —— 且完全无需任何分布式锁:
-
已密封读取窗口 (Sealed Read Windows, ⇐ W): 重试节点仅读取已密封的过去窗口,同时清理瞬时重试(偶数桶)和触发的守护标记(奇数桶)。 零幻读,零行锁。
-
即时前向写入窗口 (Immediate Write-Ahead Window, W+1): 遇到瞬时步骤故障的标准节点始终写入 W+1(下一个调度的分钟窗口,绝不写入当前窗口),写入偶数桶(
0, 2, 4),带有自动的 10 秒至 70 秒冷却缓冲。 -
远未来守护窗口 (Far-Future Watchdog Window, W+K): 启动任何事务时,标准节点在远未来窗口(例如 W + 600,即 10 小时后)中注册死人开关 (Dead-Man’s Switch) 守护行,写入奇数桶(
1, 3, 5);正常事务完成时以 O(1) 时间删除。

-
活跃写入窗口 (W+1, 重试视界): 标准节点将瞬时故障写入即时未来窗口(偶数桶:
0, 2, 4),与活跃的读取查询完全隔离。 -
已密封读取窗口 (⇐ W, 读取视界): 重试节点仅读取已完成密封的窗口。 在没有幻读或锁争用的情况下,同时处理过期的重试和逾期的守护标记。
-
远未来守护窗口 (W+K, 还原视界): 放置在远未来(例如 W + 600 分钟)奇数桶(
1, 3, 5)中的死人开关守护行。 在正常事务结束时被取消;仅在 Pod 异常崩溃时保留下来。 -
自动冷却缓冲: 写入 W+1 可在首次重试尝试前提供 10 到 70 秒的自动冷却时间,防止工作节点冲击正在重启的下游服务。
-
午夜 UTC 翻转: 窗口 1439 平滑翻转到下一个日历天(
date_of_year + 1)的第 0 分钟。
constant TOTAL_WINDOWS_PER_DAY = 1440 // 适用于 1 分钟延迟

function getCurrentReadWindow(utcTimestamp):
    minutesSinceMidnight = (utcTimestamp.hour * 60) + utcTimestamp.minute
    windowIndex = minutesSinceMidnight / delayInMinutes
    return Window(date = utcTimestamp.date, index = windowIndex)

function getImmediateRetryWriteWindow(utcTimestamp):
    readWindow = getCurrentReadWindow(utcTimestamp)
    nextIndex = readWindow.index + 1

    // 检查午夜 UTC 翻转
    if nextIndex >= TOTAL_WINDOWS_PER_DAY:
        return Window(date = utcTimestamp.date + 1 day, index = 0)
    else:
        return Window(date = utcTimestamp.date, index = nextIndex)

function getFarFutureRestoreWindow(utcTimestamp, restoreDelayWindows = 600):
    readWindow = getCurrentReadWindow(utcTimestamp)
    targetIndex = readWindow.index + restoreDelayWindows
    daysOffset = targetIndex / TOTAL_WINDOWS_PER_DAY
    finalIndex = targetIndex % TOTAL_WINDOWS_PER_DAY
    return Window(date = utcTimestamp.date + daysOffset days, index = finalIndex)
通过 Murmur3 令牌租约实现工作节点空间隔离 (Spatial Worker Isolation via Murmur3 Token Leases)
当多个重试节点并行运行时,它们必须各自处理互不重叠的工作切片,而无需数据库行锁:
-
每个标准节点在发生故障时将其
instance_id和token(instance_id)注册在第 3 层 (es_instances_by_recovery_window)。 -
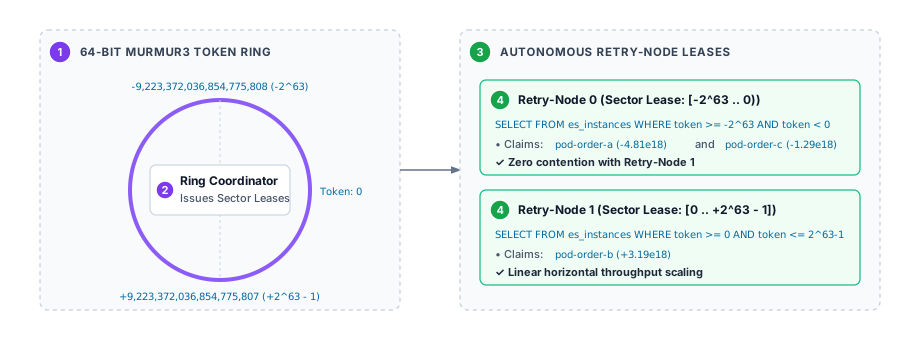
环形协调器将 64 位令牌环 (
-2^63至2^63 - 1) 划分为互不重叠的扇区租约,并为每个活跃的重试节点分配一个租约。 -
每个重试节点使用其承租的令牌边界查询第 3 层:
SELECT instance_id, instance_id_token
FROM es_instances_by_recovery_window
WHERE region = :region AND cluster = :cluster AND service_name = :service_name
  AND date_of_year = :date AND minute_of_day = :window
  AND instance_id_token >= :lease_min_token
  AND instance_id_token <= :lease_max_token;
由于租约不重叠,两个重试节点绝不会处理相同的实例。 随着添加更多重试节点,吞吐量呈线性扩展。 每个查询都会验证当前时间戳是否在租约有效期内;如果租约因网络分区而过期,执行立即终止,防止出现脑裂处理。
-
64 位 Murmur3 令牌环: 范围跨越
-2^63至+2^63 - 1。 -
环形协调器: 将令牌环划分为不重叠的扇区并颁发有时限的租约。
-
工作节点租约: 每个重试节点使用其承租的扇区边界(
WHERE token >= min AND token < max)查询第 3 层。 -
自治切片: 线性水平扩展,零重复处理,零数据库行锁。
处理重试桶:逐步执行流程 (Processing a Retry Bucket: Step-by-Step)
一旦重试节点在其租约令牌范围内识别出一个 instance_id,它将执行以下步骤:
-
读取第 4 层 (
es_buckets_by_instance) 以发现该实例在当前窗口下的所有桶索引。 -
读取第 5 层 (
es_recovery_transactions_by_instance) 针对每个偶数桶流式读取transaction_id指针。 -
使用
transaction_id从es_transaction中延迟获取 Saga 载荷。 -
以受控的并发度 (
recovery.concurrency,默认值:100)重新调用 Saga 步骤。 -
当桶中的所有事务都被调度分发后,从第 5 层清理该桶分区:
DELETE FROM es_recovery_transactions_by_instance
WHERE region = :region AND cluster = :cluster AND service_name = :service_name
  AND date_of_year = :date AND minute_of_day = :window
  AND instance_id = :instance_id AND bucket_index = :bucket_index;
由于删除针对的是复合分区键,Cassandra 写入的是单个分区墓碑 (Partition Tombstone),而不是数千个单元格墓碑。 在 SSTable 压缩期间,Cassandra 会在 O(1) 时间内丢弃整个分区。
-
在第 5 层分区清理后,立即从
es_buckets_by_instance中删除第 4 层的桶索引行。 -
当该实例的所有桶均处理完毕后,删除第 3 层的实例标记。
|
步骤间崩溃的幂等性 (Crash-Between-Steps Idempotency): |
安全停机与零数据丢失保证 (Safe Shutdown & Zero Data Loss Guarantee)
如果 Kubernetes 在重试节点处理 50,000 个事务的过程中强行终止了该节点,会发生什么?
遍历管道强制执行严格的停机不变量:除非 100% 的事务都已被成功分发,否则绝不删除桶分区:
function onBucketBatchComplete(bucket, totalTransactions, executedCount):
    // 如果工作节点正在停机 或 并非所有事务都已执行
    if isShutdownRequested() or executedCount < totalTransactions:
        log.info("Worker shutting down or partial execution. Preserving bucket in Cassandra.")
        return // 绝不删除桶分区!

    // 仅当 100% 的事务都已分发时才删除分区
    dropBucketPartition(bucket)
    deleteBucketIndex(bucket)
当重试节点在桶处理中途中断被杀时,该分区在 Cassandra 中保持完好无损。
重启后,下一个工作节点从第 1 行开始接管该桶。
执行标记 (es_execution_markers) 确保已完成的 Saga 步骤被检测为 COMMITTED 并立即跳过,无需重新调用下游 API —— 仅执行真正未完成的步骤。
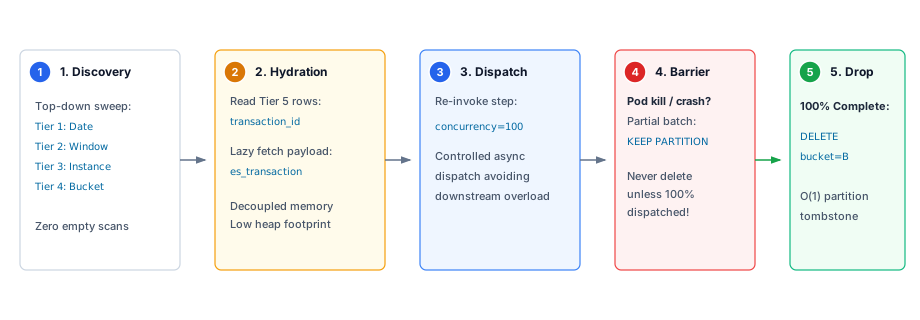
-
发现: 自顶向下从第 1 层扫描至第 4 层,无空表扫描。
-
水合: 从第 5 层流式传输轻量级指针,并从
es_transaction延迟获取载荷。 -
分发: 并发重新调用,最大达到
recovery.concurrency(默认值:100)。 -
安全停机屏障: 如果 Pod 在桶中途被终止,分区在 Cassandra 中得以保留;重启后跳过已完成步骤。
-
O(1) 压缩清理: 当 100% 分发完成后,使用单个分区墓碑丢弃整个桶分区。
深度历史恢复 (Deep Historical Recovery)
如果我们的整个服务在整个周末都处于离线状态 —— 这些失败的事务是否会被遗弃?
绝不会。
启动时,工作节点根据 recovery.lookback-days(默认值:2)生成倒推数天的候选日期。
工作节点按升序遍历第 1 层(date_of_year ASC)和第 2 层(minute_of_day ASC),按时间顺序恢复周五、周六和周日的积压任务,然后平滑过渡到实时流。
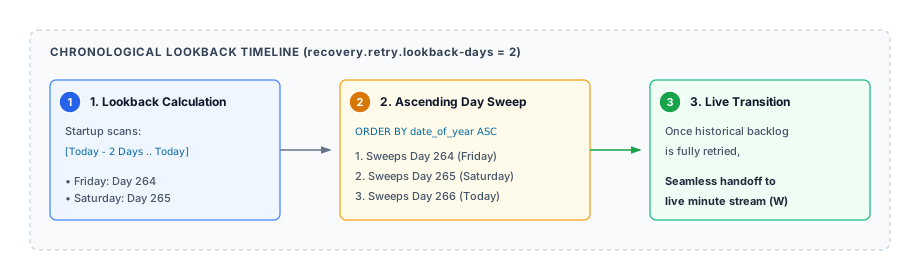
-
回溯范围计算: 启动时,工作节点根据
recovery.lookback-days计算候选日期。 -
升序日期扫描: 工作节点按升序遍历第 1 层(
date_of_year ASC),优先恢复较旧的积压。 -
实时平滑过渡: 一旦历史窗口处理完毕,工作节点平滑过渡到当前分钟实时流 (W)。
功能特性 2:还原 (Feature 2: Restore)
核心问题:无感崩溃 (The Problem: The Silent Crash)
重试 (Retry) 处理的是能够被显式检测到的故障 —— 步骤已运行,下游服务返回了错误,StackSaga 记录了该错误。 但请考虑一种异常崩溃场景:
-
用户提交订单。
-
一个
order-servicePod 开始执行 Saga —— 在库存服务中预留了库存。 -
执行中途,在调用支付服务之前,宿主机遭遇灾难性断电或 OOM 终止。
-
Pod 瞬间消失。 未记录任何错误。 未创建任何重试记录。
-
当替代 Pod 启动时,其内存中完全没有事务
T-12345曾经存在的任何记录。
如果没有专门的机制,事务 T-12345 将永远孤立在不一致的分布式状态中。
还原 (Restore) 功能通过死人开关模式 (Dead-Man’s Switch Pattern) 解决了这个问题:在事务开始时写入一条守护行 (Watchdog Row),在事务正常完成时将其删除。
如果事务未能完成,守护行将得以保留并触发自动化恢复。
还原运作机制:死人开关 (How Restore Works: The Dead-Man’s Switch)
当标准节点开始处理任何事务时,它会立即执行:
-
计算一个远未来还原窗口 (Far-Future Restore Window):
restore_window = current_window + (recovery.restore.domains.<domain>.delay-windows * recovery.window-interval-minutes) 示例: window-interval-minutes = 1 (1 分钟窗口) restore.domains.default.delay-windows = 600 → 守护行被放置在目录树中 600 分钟(10 小时)后的未来窗口中 -
在该还原窗口的第 5 层奇数桶 (Odd Bucket) 中写入一条轻量级守护行。
-
将完整的分区路径
(date, window, instance_id, odd_bucket_index)持久化保存在es_transaction记录中。
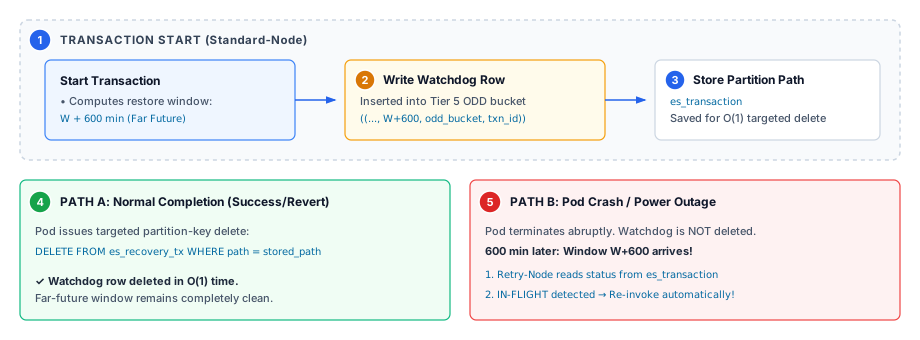
-
事务启动: 标准节点在远未来窗口 W + 延迟(例如 +600 分钟)注册守护行。
-
奇数桶中的守护标记: 写入第 5 层奇数桶分区。
-
路径存储在账本中: 分区路径保存在
es_transaction中以便针对性删除。 -
路径 A(正常完成): 定向 O(1) 删除操作移除守护行;窗口保持干净。
-
路径 B(Pod 崩溃): 守护行在 Cassandra 中持久保留。 当该时间窗口到来时,重试节点检查状态并自动重新调用。
| 结果 | 处理流程 |
|---|---|
事务正常完成 |
标准节点从 |
Pod 在事务中途崩溃 |
守护行从未被删除。当远未来窗口最终到达并变成已密封读取窗口 (⇐ W) 时,重试节点通过正常的 5 层遍历发现它,检查状态,并自动重新调用该事务。 |
还原拾取时的状态检查 (Status Check on Restore Pickup)
当重试节点从还原桶(奇数 bucket_index)中获取事务时,Saga 引擎在尝试重新调用之前会对 es_transaction.running_status 执行强制性状态检查:
status = SELECT running_status FROM es_transaction WHERE transaction_id = :id

if status == PROCESS_COMPLETED or status == REVERT_COMPLETED:
    // 事务已完成。守护行删除操作必定是在完成时因网络抖动而失败。
    // 静默删除守护行并跳过。
    deleteRestoreRow(path)
    return

// 状态显示事务仍在进行中(或未知)。重新调用它。
reInvoke(transaction)这保证了对已完成事务的至多一次重新调用 (At-most-once re-invocation),以及对真正孤立事务的至少一次恢复 (At-least-once recovery)。
为什么还原桶使用奇数索引 (Why Restore Buckets Use Odd Indexes)
还原记录与重试记录共享相同的第 5 层表,严格通过 bucket_index 进行区分:
-
偶数桶索引 (0, 2, 4 …) → 重试 (Retry) 记录。 仅在瞬时故障时写入。
-
奇数桶索引 (1, 3, 5 …) → 还原 (Restore) 记录。 在每次事务启动时写入。
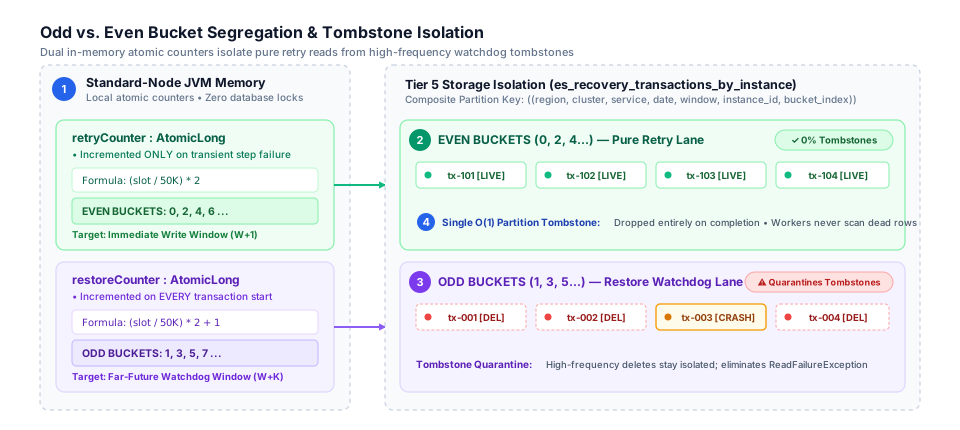
-
双内存计数器: 针对重试(偶数)和还原(奇数)的独立
AtomicLong计数器。 -
偶数桶(纯重试): 0% 单元格墓碑。 读取性能极高,通过单分区墓碑整体清理。
-
奇数桶(还原守护标记): 将已完成事务所产生的高频单元格墓碑与重试读取完全隔离,杜绝
ReadFailureException。 -
O(1) 分区墓碑: 整个偶数桶在完成时通过单次元数据操作整体丢弃;重试工作节点绝不扫描已删除行。
为什么奇偶隔离在结构上至关重要:
1. 墓碑隔离 (Tombstone Isolation): *每个*事务启动时都会写入还原行,并在数分钟后成功时将其删除。
这会产生密集的单元格墓碑累积。
如果将还原行混合到重试桶中,扫描重试行的重试节点将不得不读取成千上万个墓碑,从而面临 ReadFailureException(超过 100,000 个墓碑)的风险。
将还原隔离到奇数桶可确保重试桶 100% 无墓碑。
2. 准确的活跃行计数 (Accurate Live-Row Counting): 内存中的 AtomicLong 跟踪的是已写入的行数,而不是删除后剩余的行数。
将它们混在一起会导致分区基于已删除的数据行过早翻转。
3. 独立的窗口调度 (Independent Window Schedules): 重试窗口位于 1 个窗口之后 (W+1),而还原窗口位于数百个窗口之后 (W + 600)。
独立的计数器可防止不同时间点之间的写入速率产生偏差。
// 每个实例、每个写入窗口维护两个独立的 AtomicLong 计数器
retryCounter  = AtomicLong  // 对应偶数 bucket_index: 0, 2, 4 ...
restoreCounter = AtomicLong  // 对应奇数  bucket_index: 1, 3, 5 ...

// ── 事务启动时(每个事务均执行) ─────────────────────────────
function registerRestore(transaction):
    restoreWindow = computeRestoreWindow(UTC_NOW, delayWindows)  // 远未来窗口
    slot  = restoreCounter.incrementAndGet()
    oddBucket = (slot / bucketSize) * 2 + 1                     // 1, 3, 5 ...

    insertDirectoryPath(restoreWindow, instanceId, oddBucket)    // 幂等 upsert
    path = insertRestoreMetadata(restoreWindow, instanceId, oddBucket, transaction.id)
    storeRestorePathInTransaction(transaction.id, path)          // 保存在 es_transaction 中

// ── 发生瞬时故障时(仅重试路径) ──────────────────────────────
function registerRetry(transaction):
    retryWindow = computeWriteWindow(UTC_NOW)                    // W+1
    slot  = retryCounter.incrementAndGet()
    evenBucket = (slot / bucketSize) * 2                         // 0, 2, 4 ...

    insertDirectoryPath(retryWindow, instanceId, evenBucket)
    insertRetryMetadata(retryWindow, instanceId, evenBucket, transaction.id)

// ── 事务正常完成时(成功) ──────────────────────────────────
function onTransactionComplete(transaction):
    path = getRestorePathFromTransaction(transaction.id)
    deleteRestoreRow(path)   // O(1) 针对分区键的直接定向删除
通过虚拟集群与单元隔离实现水平扩展 (Horizontal Scaling via Virtual Clusters & Cell Isolation)
实例级分桶将单个 Pod 的分区限制在 50,000 行以内。 然而,超大规模微服务部署面临着一个集群范围的上限:单个分钟窗口内的活动 Pod 总数。
第 3 层分区容量指导:单服务 50,000 个 Pod 的上限 (Tier 3 Partition Sizing Guidance: The 50,000 Pod Ceiling per Service)
为什么 50,000 个 Pod 是上限,它适用于什么范围?
回顾第 3 层 (es_instances_by_recovery_window) 的主键结构:
PRIMARY KEY ((region, cluster, service_name, date_of_year, minute_of_day), instance_id_token, instance_id)在第 3 层中,在给定分钟窗口内注册故障的每个独立 Pod 都会向分区 region, cluster, service_name, date_of_year, minute_of_day 中插入一个目录标记。
默认情况下,区域内的所有 Pod 都属于名为 default 的单个集群。
|
关键范围:同一编排服务的 50,000 个 Pod,而非整个集群 (Critical Scope: 50,000 Pods of the SAME Orchestration Service, NOT the Entire Cluster):
在实践中,生产微服务通常每个服务扩展到几十、几百或最多几千个副本。 在正常操作下,单个第 3 层分区通常仅包含几十到几百行。 |
基于虚拟集群的单元隔离 (Cell Isolation via Virtual Clusters)
对于确实运行单个编排服务超过 50,000 个副本的超大规模企业部署,StackSaga 通过虚拟集群 (Virtual Clusters) 解决了这一可扩展性上限,而无需单独的物理数据库基础设施:
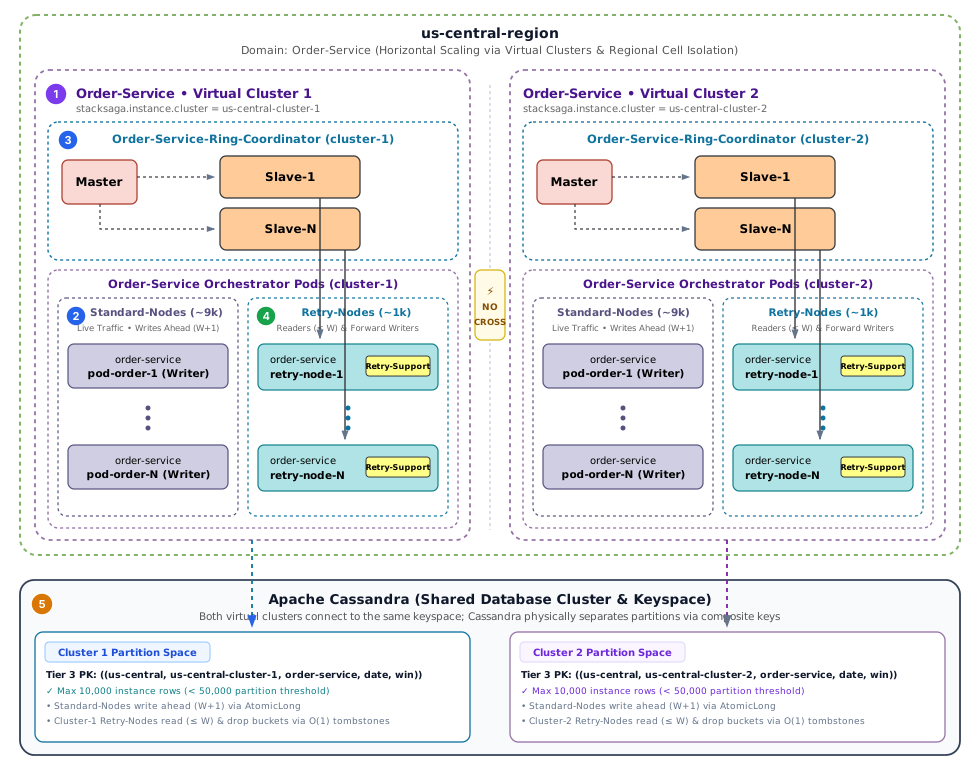
-
虚拟集群单元隔离 (
stacksaga.instance.cluster): 每个虚拟集群形成一个完全独立自包含的自治处理单元 (Cell)。us-central-cluster-1中的故障、网络分区或高流量突发对us-central-cluster-2毫无运行影响。 -
标准节点(实时流量写入者): 大多数编排器 Pod(例如每个集群 9,000 个 Pod)处理面向用户的实时事务。 在发生瞬时故障时,它们使用本地内存
AtomicLong计数器向前写入其分配集群分区的窗口 W+1 —— 无需跨集群协调。 -
严格的 1:1 环形协调器映射: 每个虚拟集群运行其专属的专用环形协调器集群(Master 与 Slaves)。 不存在跨集群的协调器流量或共享状态。
us-central-cluster-1的环形协调器专门为配置了cluster = us-central-cluster-1的重试节点提供服务,确保零跨集群协调开销。 -
重试节点(双重角色:读取者与前向写入者): 重试节点从其集群的环形协调器租用不重叠的令牌扇区,并扫描已密封的读取窗口 (⇐ W)。 重要的是,重试节点也是前向写入者:当重试尝试本身再次失败时,重试节点原子递增其本地
AtomicLong,并将事务重新注册到自己集群的窗口 W+1 中 —— 与标准节点具有相同的写入路径。 -
共享 Cassandra 键空间(物理分区隔离): 区域内的所有虚拟集群均连接到相同的 Cassandra 键空间。 由于 Cassandra 对复合分区键
region, cluster, service_name, date_of_year, minute_of_day进行哈希,来自us-central-cluster-1和us-central-cluster-2的数据落在完全独立的物理分区中。 即使区域内活跃的总 Pod 超过 50,000 个,每个虚拟集群的第 3 层分区仍远低于 10,000 行 —— 保持了最佳的读取延迟和压缩效率。
通过在 application.yml 中设置 stacksaga.instance.cluster,Pod 被分配到隔离的虚拟集群:
# 虚拟集群 1 中的 Pod
stacksaga:
  instance:
    region: us-central
    cluster: us-central-cluster-1

# 虚拟集群 2 中的 Pod
stacksaga:
  instance:
    region: us-central
cluster: us-central-cluster-2|
当声明自定义区域名称(如 |
每个虚拟集群都运行其*专属的环形协调器部署*,零跨集群协调开销。
由于 cluster 是复合分区键的一部分,数据落在完全独立的物理分区中,从而保持了最佳的读取延迟和压缩效率。
目录压缩:Node-0 压缩监管节点与工作节点职责 (Directory Compaction: Node-0 Compactor Overseer vs. Worker Responsibilities)
当重试节点完成处理给定窗口中某个实例的所有桶时,它会: 1. 从第 5 层丢弃每个已完成的桶分区(单分区墓碑 —— O(1))。 2. 从第 4 层删除桶索引行。 3. 从第 3 层删除其自身的实例标记。
由谁来从第 2 层删除已完成的分钟窗口以及从第 1 层删除日历日期?每个重试节点可以删除自己的分钟窗口吗?
不行 —— 这是一个关键的设计核心点。
在 StackSaga 的重试架构中,Node-0 既不是独立的服务,也不是单独的二进制程序。
它只是恰好持有环形协调器颁发的锚点(最低)令牌范围租约的活跃重试节点。
过早删除风险 (The Premature Deletion Hazard)
假设有两个重试节点正在处理第 500 分钟窗口: * 重试节点 1 (Retry-Node 1) 仅有 5 个事务,并在 100ms 内完成。 * 重试节点 2 (Retry-Node 2) 有 40,000 个事务,仍在运行中。
如果允许重试节点 1 立即从 es_recovery_windows_by_day 中删除第 500 分钟,该窗口就会从目录中消失。
如果重试节点 2 随后发生重启(例如被 Kubernetes 驱逐 Pod),它会通过扫描第 2 层来重新发现工作 —— 但此时第 500 分钟已经消失,那 40,000 个事务将被永久遗弃。
职责划分 (Responsibilities Breakdown)
压缩职责在常规工作节点和 Node-0 之间进行了清晰的划分:
| 职责 | 常规重试工作节点 (Node-1, Node-2 等) | Node-0 (压缩监管节点,Compactor Overseer) |
|---|---|---|
工作范围 |
仅处理与其分配的令牌租约匹配的实例。 |
检查跨所有令牌范围的集群全局状态。 |
压缩目标 |
- 第 5 层:有界桶分区 ( |
- 第 2 层:分钟窗口记录 ( |
执行时机 |
每个桶或实例完成时立即运行。 |
在周期性循环中运行,验证已密封的窗口。 |
Node-0 的双门禁验证协议 (Node-0’s Two-Gate Verification Protocol)
在从第 2 层删除任何分钟窗口之前,Node-0 必须通过两道门禁:
-
门禁 1(全集群法定人数,Cluster-Wide Quorum): Node-0 在不进行令牌过滤的情况下查询整个集群的第 3 层:
SELECT instance_id FROM es_instances_by_recovery_window
WHERE region = :region AND cluster = :cluster AND service_name = :service_name
  AND date_of_year = :date AND minute_of_day = :window;
如果在集群任何位置存在任何实例标记,Node-0 均保持等待。
-
门禁 2(挂钟检查,Wall-Clock Check): Node-0 验证当前 UTC 时间已超过窗口 W 的结束时间。 即使所有实例标记均已清除,等待也能确保没有来自标准节点的延迟写入跨入该窗口。
只有当两道门禁全部通过时,Node-0 才会安全地从第 2 层中移除该分钟窗口。一旦某个日历日期的所有分钟窗口全部清除,Node-0 将从第 1 层中删除该日期。
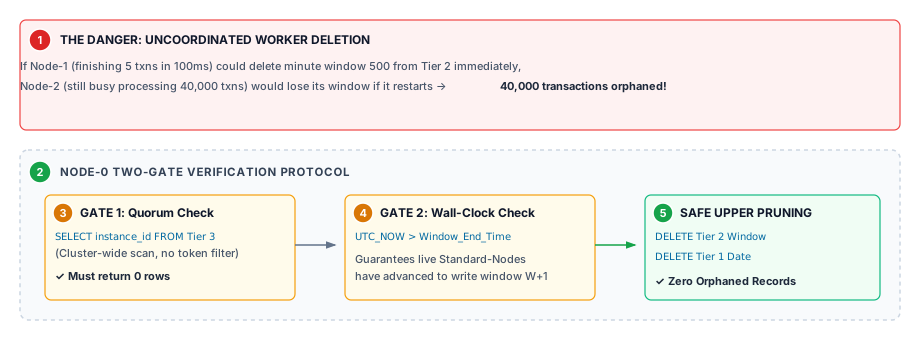
-
过早删除风险: 未经协调的工作节点删除会导致对等节点的活动事务孤立。
-
Node-0 压缩监管节点: 删除共享上层目录(第 2 层和第 1 层)的唯一权威。
-
门禁 1(全集群法定人数): 对第 3 层的全集群查询必须返回 0 行。
-
门禁 2(挂钟检查): 验证当前 UTC 时间已走过窗口结束时间。
-
安全上层剪枝: 安全删除第 2 层分钟窗口和第 1 层日历日期。
第 3 层墓碑行为与风险评估 (Tier 3 Tombstone Behavior & Risk Profile)
门禁 1 扫描引出了一个细微但至关重要的 Cassandra 墓碑考量,系统工程师应当对此有所了解。
墓碑如何在第 3 层累积:
当重试节点完成给定实例的所有桶时,它会对 es_instances_by_recovery_window 执行针对聚类行的定向 DELETE:
DELETE FROM es_instances_by_recovery_window
WHERE region = :region AND cluster = :cluster AND service_name = :service_name
  AND date_of_year = :date AND minute_of_day = :window
  AND instance_id_token = :token AND instance_id = :id;
在 Cassandra 中,删除聚类行会向 SSTable 中写入一个单元格墓碑 (Cell Tombstone) —— 而不是像第 5 层桶清理那样的 O(1) 分区墓碑。
当 Node-0 随后运行门禁 1(对该 (date, window) 分区进行全分区扫描以验证剩余 0 个实例)时,它必须读取所有累积的单元格墓碑,然后才能返回空结果集。
如果读取跨越超过 100,000 个墓碑,Cassandra 将中止并抛出 ReadFailureException。
为什么该问题在结构上是自收敛的:
与第 5 层还原行(在每次事务启动时写入)不同,第 3 层数据行仅在 Pod 真正经历瞬时故障时才会写入 —— 这是一个频率低得多的事件。 多项架构约束共同作用,将墓碑累积牢牢限制在 100,000 阈值以下:
| 约束条件 | 对第 3 层墓碑累积的影响 |
|---|---|
仅故障时写入 |
第 3 层数据行仅在步骤发生瞬时故障时插入 —— 而不是在每次事务启动时。
在健康的系统中,导致瞬时故障的事务比例很小,因此每个分钟窗口写入的唯一 |
虚拟集群分区隔离 |
复合分区键包含 |
删除与门禁 1 之间的短生命周期 |
Node-0 的门禁 1 扫描仅在所有重试节点确认它们已完成窗口后执行。 在实践中,这是一个较短的时间间隔 —— 通常在同一个压缩周期内。 Cassandra 的 Memtable 和近期的 SSTable 刷新可能已经在门禁 1 执行之前部分吸收或合并了墓碑,进一步减少了有效墓碑读取计数。 |
单分区精确键扫描 |
门禁 1 针对的是精确的复合分区键( |
按部署场景的风险评估:
| 部署场景 | 风险级别 | 指导建议 |
|---|---|---|
正常部署 —— 每个分钟窗口有数十至数百个发生故障的独立 Pod |
🟢 可忽略 |
墓碑数量比 100,000 阈值低数个数量级。无需特殊调优。 |
正确配置了虚拟集群的大型部署 |
🟢 低 |
每个集群的第 3 层分区设计上保持远低于 10,000 行。标准的 |
极高的 Pod 流转率 —— 每分钟有数千个独立的 |
🟡 中等 |
如果压缩跟不上,墓碑可能会跨多个窗口堆积。
增加虚拟集群粒度 ( |
单个集群 —— 同一编排服务有 50,000+ 个同时发生故障的活跃 Pod,未配置虚拟集群分离 |
🔴 风险 |
该场景已违背了文档中说明的 第 3 层分区容量指导。 应立即将 Pod 划分为虚拟集群,使每个第 3 层分区重新回到安全行数预算之内。 |
|
与第 5 层奇数桶的对比: |
按领域实体的还原与重试延迟配置 (Per-Domain-Entity Restore & Retry Delay Configuration)
不同的 Saga 类型可能会因纯系统级因素(下游微服务跳数、网络往返时间以及外部 API 响应时间)而具有显著不同的执行时长 —— 而不是出于业务领域决策。
例如:
-
调用单个内部服务的
notification-saga耗时仅数毫秒。 10 小时后的还原守护标记显得过于遥远 —— 如果 Pod 崩溃,孤立检测将被推迟过长时间。 -
跨多个区域编排 8 个下游服务的
order-saga在降级网络条件下可能合理地需要 20–30 分钟。 如果全局还原延迟过短,守护标记可能会在 Saga 仍在健康的 Pod 上运行时触发,从而引发虚假的状态检查与重新调用循环。
StackSaga 在 stacksaga.cassandra.recovery.retry.domains 和 stacksaga.cassandra.recovery.restore.domains 下提供了按领域实体的延迟窗口覆盖,并自动回退到 default 配置:
application.yml 示例stacksaga:
cassandra:
recovery:
retry:
domains:
default:
delay-windows: 1 # 全局默认:W+1(下一个窗口)
order-saga:
delay-windows: 3 # W+3 —— 为较慢的外部 API 提供更长的冷却时间
payment-saga:
delay-windows: 1
restore:
domains:
default:
delay-windows: 600 # 全局默认:10 小时后 (600 × 1 分钟)
order-saga:
delay-windows: 1200 # 20 小时 —— 多跳编排 Saga
payment-saga:
delay-windows: 300 # 5 小时 —— 较短的生命周期
notification-saga:
delay-windows: 60 # 1 小时 —— 快速通知生命周期为什么目录结构无需任何更改:
delay-windows 的值仅在写入时使用(即标准节点在故障时前向预写或在事务启动时注册守护行)。
每个事务独立地将其完整的守护标记分区路径(restore_date, restore_window, restore_instance_id, restore_bucket)存储在 es_transaction 中。
重试节点通过正常的 5 层遍历发现并处理守护行和重试行 —— 它们无需感知记录属于哪个领域实体。
这意味着:
-
落在
W+300的payment-saga守护标记和落在W+1200的order-saga守护标记跨不同窗口共存于同一个第 5 层表中 —— 由相同的管道以零结构变更进行处理。 -
领域级回退到
default是无缝的 —— 任何没有显式覆盖的领域都会自动继承domains.default.delay-windows。 -
无需变更数据库模式,无需新表,无需新增层级。
配置属性参考 (Properties Reference)
以下属性用于配置 Cassandra 响应式支持模块。
| 属性名称 | 默认值 | 类型 | 描述 |
|---|---|---|---|
连接属性 (Connection Properties) |
|||
|
|
|
读取操作的一致性级别。 |
|
|
|
写入操作的一致性级别。 |
|
|
|
DataStax Java 驱动配置文件的路径。 |
写入保护属性 (Write Protection Properties)(在 |
|||
|
|
|
应用于未指定按领域覆盖的 Saga 的默认写入保护模式。 |
|
|
|
|
|
|
|
按领域实体名称键控的特定领域一致性模式覆盖。 |
|
|
|
|
事务生命周期 (Transaction Lifetime) |
|||
|
|
|
事务在事件存储中保持活动的时长。超过此阈值后,停滞的事务将被隔离,不再暴露用于自动恢复。 |
恢复引擎 —— 共享属性 (Recovery Engine — Shared Properties)(在 |
|||
|
|
|
离散时间窗口的粒度(以分钟为单位)。必须能整除 1440。 |
|
|
|
每个恢复桶分区的最大行数。由重试(偶数桶)和还原(奇数桶)共享。当实例的计数器达到此限制时,它会自动原子翻转到下一个桶索引,使所有分区严格保持在 100MB 以下(约 3–5MB)。 |
|
|
|
重试节点在桶处理期间并发分发以重新调用的最大事务数。 |
|
|
|
工作节点启动时向后扫描的历史日历天数( |
恢复引擎 —— 重试专属属性 (Recovery Engine — Retry-Specific Properties)(在 |
|||
|
|
|
调度待重试事务的默认提前窗口数 (W+1)。 |
|
|
|
按领域覆盖的重试延迟窗口数。允许为具有较慢外部依赖项的 Saga 提供更长的冷却窗口。未设置时回退到 |
恢复引擎 —— 还原专属属性 (Recovery Engine — Restore-Specific Properties)(在 |
|||
|
|
|
事务启动时放置还原守护行的默认提前窗口数(相对于 |
|
|
|
按领域覆盖的还原守护延迟窗口数。允许快速 Saga 使用较短的守护窗口(例如 60 分钟),多跳编排 Saga 使用较长的守护窗口(例如 1200 分钟)。未设置时回退到 |
在 stacksaga.cassandra.recovery.retry.domains.<domain-name> 和 stacksaga.cassandra.recovery.restore.domains.<domain-name> 下按 Saga 领域实体覆盖 delay-windows,可为快速 Saga 提供更短的守护窗口,为多跳编排 Saga 提供更长的窗口 —— 且无需更改任何数据库模式或目录结构。
参见 按领域实体的还原与重试延迟配置。
|
application.yml 示例stacksaga:
instance:
region: us-central
cluster: us-central-cluster-1
cassandra:
read-consistency-level: LOCAL_QUORUM
write-consistency-level: LOCAL_QUORUM
config: classpath:stacksaga-cassandra.conf
transaction:
lifetime: 24h # 停滞事务的隔离阈值
write-protection:
default-mode: RELAXED_WITH_DEDUP # 默认采用高吞吐读取检查模式
default-lease-duration: 5s # STRICT 模式下的默认 LWT 租约 TTL
domains:
payment-saga:
mode: STRICT # 支付采用严格互斥
lease-duration: 10s
order-saga:
mode: STRICT
notification-saga:
mode: RELAXED_WITH_DEDUP
recovery:
concurrency: 100 # 每个周期的并发重新调用数
window-interval-minutes: 1 # 每天 1440 个离散窗口
bucket-size: 50000 # 每个分区最大约 5MB(重试 + 还原共享)
lookback-days: 2 # 最多回溯扫描 2 天的历史故障
retry:
domains:
default:
delay-windows: 1 # 全局默认重试延迟 (W+1)
order-saga:
delay-windows: 3 # 针对较慢外部依赖的自定义 W+3 重试延迟
restore:
domains:
default:
delay-windows: 600 # 全局默认:提前 600 分钟 (600 × 1 min = 10h)
order-saga:
delay-windows: 1200 # 多跳 Saga 提前 20 小时
notification-saga:
delay-windows: 60 # 快速 Saga 提前 1 小时常见问题解答:架构深度探讨 (Frequently Asked Questions: Architectural Deep-Dive)
本节解答开发人员、Cassandra DBA 以及平台 SRE 在高吞吐生产环境中部署 StackSaga 时经常提出的架构、运维和数据库工程问题。
类别 1:Cassandra 数据建模与分区容量 (Category 1: Cassandra Data Modeling & Partition Sizing)
Q1: 第 3 层中的 50,000 个 Pod 上限是否意味着我们的整个 Kubernetes 集群不能超过 50,000 个 Pod?
不是。 50,000 个 Pod 的阈值仅针对每个编排服务 (service_name) 独立生效,而不是跨整个 Kubernetes 集群生效。
-
非编排 Pod 不计入: 在运行数万个 Pod 的现代企业 Kubernetes 集群中,绝大多数代表非编排工作负载(例如 API 网关、UI 前端、DaemonSet、缓存服务、未使用 StackSaga 的独立微服务)。 这些工作负载从不写入 StackSaga 的恢复表。
-
每个服务实体独立的 50,000 限额: 当多个不同的编排服务(
order-service、payment-service、shipping-service)运行在同一个 Kubernetes 集群中并共享同一个 Cassandra 键空间时,每个服务都会获得其专属的独立 50,000 个 Pod 分区配额。 这是因为service_name是第 3 层复合分区键的显式强制组成部分:PRIMARY KEY ((region, cluster, service_name, date_of_year, minute_of_day), instance_id_token, instance_id)order-service和payment-service的数据会哈希到完全不同的 Cassandra 节点和物理 SSTable 上。 一个运行 30,000 个order-servicePod 和 40,000 个payment-servicePod(总共 70,000 个 StackSaga Pod)的集群能够完全安全地运行,因为两个服务都不会接近其各自的 50,000 上限。 -
真正的操作阈值: 仅当完全相同的编排服务的 50,000 个副本全部在完全相同的 60 秒窗口内经历瞬时故障时,第 3 层才会接近 Cassandra 建议的分区限制(< 50,000 行 / < 100MB)。 在正常操作下,即使是大型微服务也会扩展到数百或几千个副本,且只有一小部分会同时经历瞬时重试。
参见 第 3 层分区容量指导 和 通过虚拟集群与单元隔离实现水平扩展。
Q2: 为什么 Saga 事务载荷不会导致第 5 层恢复分区超出 Cassandra 100MB 的分区限制?
因为 5 张恢复目录表中绝不存储任何业务载荷或领域状态。
无论 Saga 的载荷是 100 字节的 JSON 订单还是庞大的序列化领域实体图,第 5 层行 (es_recovery_transactions_by_instance) 严格仅存储微小的元数据指针(约 50 至 100 字节):transaction_id、running_status 和目标路由标记。
实际的 Saga 状态、步骤参数、执行历史和序列化载荷完全保存在核心事件存储(es_transaction 和 es_transaction_tryout)中,它们由 transaction_id 单独分区(O(1) 点查)。
每行元数据约 50–100 字节: * 包含 10,000 行的桶仅占用约 800KB。 * 即使完全装满 50,000 行的桶在磁盘上也仅占用约 3MB 至 5MB。
因此,无论您的业务事务载荷有多大,恢复分区在物理上都绝不可能违反 Cassandra 的 100MB 限制。
参见 有界分区:实例级本地分桶。
Q3: 如果主要下游服务宕机且数千个 Pod 同时失败,它们是否会造成单个 Cassandra 协调节点的热点?
不会。 StackSaga 有意避免了全局共享分区、全局序列生成器和集中式计数器。
当数千个 Pod 同时经历下游超时时:
-
本地原子分区: 每个 Pod 递增其自己的内存
AtomicLong计数器,并写入其在第 5 层中专属的实例独立分区(region, cluster, service_name, date, window, instance_id, bucket_index):PRIMARY KEY ((region, cluster, service_name, date_of_year, minute_of_day, instance_id, bucket_index), transaction_id) -
全环令牌分布: 因为 Cassandra 使用 Murmur3 对分区键进行哈希,数千个发生故障的实例会在整个 Cassandra 环上产生数千个截然不同的令牌哈希。 写入流量均匀分布在数据中心的每个 Cassandra 节点上,消除了协调器热点。
-
时间隔离: 实时 Pod 向前写入未来的 W+1 窗口。 恢复工作节点仅从过去已密封的窗口 (⇐ W) 中读取。 写入路径和恢复读取路径绝不会在同一时刻触及相同的分区。
参见 有界分区:实例级本地分桶 和 三元窗口同步模型。
类别 2:墓碑与压缩安全 (Category 2: Tombstones & Compaction Safety)
Q4: 为什么 StackSaga 将重试和还原隔离到偶数桶和奇数桶中,这如何防止 Cassandra 发生 ReadFailureException?
偶数桶和奇数桶的隔离将正常事务完成所产生的高频单元格墓碑隔离开来,保护了纯净的重试扫描路径。
-
偶数桶(纯重试 —— 0, 2, 4…): 仅在发生瞬时故障时写入。 当桶中的所有重试完成后,整个分区通过 O(1) 分区墓碑 (Partition Tombstone) 在单次元数据操作中整体删除。 读取偶数桶的重试工作节点扫描的是100% 活跃行,0% 单元格墓碑。
-
奇数桶(还原守护标记 —— 1, 3, 5…): 作为死人开关守护标记在每次事务启动时写入。 在正常运行条件下,99.9%+ 的事务成功完成,从而触发针对单行的定向删除(
DELETE FROM … WHERE transaction_id = :id)。 在 Cassandra 中,单行删除会写入单元格墓碑 (Cell Tombstones)。 -
所防止的墓碑危害: 如果重试和还原共享同一个桶分区,扫描 50,000 行的重试工作节点将遇到来自已完成事务的数万个单元格墓碑。 在单个读取查询路径中扫描超过 100,000 个墓碑会导致 Cassandra 中止并抛出致命的
ReadFailureException。 -
解决方案: 通过将守护标记隔离到奇数桶中,高频单元格墓碑绝不会污染重试路径。 偶数桶保持 100% 无墓碑,确保了可预测的亚毫秒级恢复扫描。
参见 为什么还原桶使用奇数索引。
Q5: 当重试节点从第 3 层删除已完成的实例时,为什么 Node-0 在门禁 1 验证检查期间不会遭遇墓碑风暴?
当重试节点完成某个实例的所有桶时,它会从第 3 层删除该实例的聚类行(DELETE FROM es_instances_by_recovery_window WHERE … AND instance_id = :id),写入一个单元格墓碑。
当 Node-0 执行门禁 1(在清理第 2 层之前验证剩余 0 个实例)时,它会扫描该 (date, window) 分区。
这在结构上是安全的,不会触发 Cassandra 的 100,000 墓碑上限,原因如下:
1. 仅故障时写入: 第 3 层数据行代表在该特定 60 秒窗口内发生故障的唯一 Pod,而不是单个事务。
在典型的企业微服务中,每分钟只有几十或数百个独立的 Pod 实例会经历瞬时错误。
2. 虚拟集群边界约束: 复合分区键包含 cluster。
工作负载被约束在每个单元远低于 10,000 个 Pod 的范围内 —— 比 100,000 墓碑限制低整整一个数量级。
3. 针对性分区扫描: 门禁 1 针对精确的复合分区键(region + cluster + service_name + date + minute),读取单次内存中分区,无需跨节点范围扫描或 ALLOW FILTERING。
Q6: 谁来清理已完成的分钟窗口和日历日期?如果每个工作节点都删除自己的窗口,会导致什么问题?
第 2 层 (es_recovery_windows_by_day) 和第 1 层 (es_days_by_year) 是由所有恢复工作节点遍历的共享目录索引。
-
过早删除风险: 如果允许单个工作节点在其分配的令牌扇区完成后立即删除第 2 层分钟窗口,就会发生不可恢复的竞态条件。 假设工作节点 A 只有 5 个事务并在 50ms 内完成,而工作节点 B 有 40,000 个事务且仍在处理中。 如果工作节点 A 立即删除第 500 分钟,该窗口就会从第 2 层中消失。如果工作节点 B 随后崩溃并重启,它扫描第 2 层时会发现第 500 分钟不存在,从而永久遗弃那 40,000 个事务。
-
Node-0 压缩监管节点方案: StackSaga 将 Node-0(持有锚点令牌租约的活跃工作节点)指定为唯一有权修剪第 2 层和第 1 层的节点。
-
双门禁协议: 在从第 2 层删除任何分钟窗口之前,Node-0 必须验证:
-
门禁 1(全集群法定人数): 对第 3 层的全集群查询在所有令牌范围内返回 0 个剩余实例行。
-
门禁 2(挂钟检查): 验证当前 UTC 时间已走过窗口 W 的结束时间。 只有当两道门禁全部通过时,Node-0 才会安全地从第 2 层中移除该分钟窗口,并在日历日完成时从第 1 层中移除该日历日。
-
类别 3:并发、锁定与协调 (Category 3: Concurrency, Locking, & Coordination)
Q7: StackSaga 如何在数十个工作节点之间实现分布式恢复,而无需分布式锁(ZooKeeper、Redis 或 Cassandra Paxos/LWT)?
StackSaga 使用基于 Cassandra 原生 Murmur3 哈希环的工作节点空间隔离 (Spatial Worker Isolation) 替代了运行时数据库锁定:
-
令牌注册: 在瞬时故障注册期间,每个 Pod 将其
token(instance_id)作为聚类键与其instance_id一起写入第 3 层。 -
互斥令牌租约: RSocket 环形协调器将 64 位 Murmur3 整数空间 (
[-2^63 .. 2^63 - 1]) 划分为互不重叠的令牌扇区,并将其租给连接的重试节点。 -
分区过滤查询: 当工作节点查询第 3 层时,它使用
WHERE instance_id_token >= :min AND instance_id_token < :max限制查询。 -
零锁争用: 因为每个令牌租约都是互斥的,工作节点在物理上不可能认领同一个 Pod 的恢复桶。 工作节点并行处理事务,零锁争用,零 Paxos 协商轮次,且无需外部协调基础设施。
Q8: 三元窗口模型如何防止重试节点读取标准节点仍在活跃写入的事务?
引擎使用三个离散的时间视界在读取者和写入者之间强制执行严格的时间防火墙:
-
过去已密封窗口 (⇐ W): 只读区域。 标准节点绝不在此写入。 只有重试节点从这些窗口读取。
-
活跃写入窗口 (W+1): 标准节点使用本地
AtomicLong计数器在此处写入瞬时故障重试。 重试节点绝不从 W+1 读取,因为它尚未流逝和密封。 -
远未来还原视界 (W + delay): 标准节点在此处装载无感崩溃守护行(例如 +600 分钟 / 10 小时后)。
因为分钟窗口必须完全流逝后才能晋升为已密封的读取候选窗口,所以写入者和读取者在时间上以及 Cassandra 分区键上在物理上完全分离。 这确保了零脏读、零幻读和零数据库级锁。
参见 三元窗口同步模型。
类别 4:容错、Pod 崩溃与灾难恢复 (Category 4: Fault Tolerance, Pod Crashes, & Disaster Recovery)
Q9: 如果 Kubernetes 在重试节点处理 50,000 个事务桶的过程中将其杀死(OOM/驱逐),会发生什么?
StackSaga 提供了严格的安全停机与零数据丢失保证 (Safe Shutdown & Zero Data Loss Guarantee):
-
原子压缩屏障: 除非桶中的 100% 事务已成功分发,否则绝不删除第 5 层中的桶分区及其在第 4 层中的指针:
if isShutdownRequested() or executedCount < totalTransactions: log.info("Worker shutting down or partial execution. Preserving bucket in Cassandra.") return // 绝不删除桶分区! -
保留的工作状态: 如果重试节点在处理到 50,000 个事务中的第 25,000 个时被终止,桶分区及其第 3 层实例标记在 Cassandra 中保持完全完好。
-
幂等步骤跳过: 在工作节点重启后(或环形协调器将令牌租约重新分配给健康的节点时),新工作节点从第 1 行重新扫描该桶。为了防止前 25,000 个事务被重复执行,引擎在执行每个 Saga 步骤之前会检查
es_execution_markers。 已完成的步骤被检测为COMMITTED并立即跳过;仅执行未提交的步骤。
参见 安全停机与零数据丢失保证。
Q10: 如果编排器 Pod 无感崩溃(内核崩溃、断电、kill -9),既未执行 catch 块也未记录故障,该怎么办?
标准的 Saga 框架在异常终止期间会丢失事务,因为 Pod 在写入故障记录或发送心跳之前就已死亡。
StackSaga 通过还原死人开关 (Restore Dead-Man’s Switch) 解决了这个问题:
1. 当任何事务开始时,编排器在远未来窗口(W + delay,例如 10 小时后)的奇数桶中写入守护记录,并在 es_transaction 中持久化分区指针。
2. 正常路径: 如果 Pod 正常执行,它在事务完成时以 O(1) 时间删除守护行。
3. 崩溃路径: 如果 Pod 遭受无感崩溃,它永远不会完成,守护行将留在 Cassandra 中。
数小时后,当时间达到该未来窗口时,该窗口密封,重试节点会自动发现被遗弃的事务。
4. 强制性状态检查: 在获取还原行时,引擎查询 es_transaction.running_status。
如果事务仍在进行中,则会自动重新调用并向前推进直至完成。
参见 还原运作机制:死人开关。
Q11: 如果我们的整个微服务集群或下游依赖项整个周末都处于离线状态,旧的失败事务是否会被遗弃?
不会。 StackSaga 包含深度历史恢复 (Deep Historical Recovery) 功能。
-
启动时多天扫描: 当工作节点启动时,它们不仅仅是从当前挂钟分钟开始侦听。 它们根据
recovery.lookback-days(默认:2 天,可配置为任意时长)向后查询第 1 层 (es_days_by_year)。 -
按时间升序遍历: 工作节点按升序遍历历史日历天(
date_of_year ASC)并按升序遍历历史分钟窗口(minute_of_day ASC),在平滑过渡到实时流量之前系统地处理周五、周六和周日累积的积压。 -
隔离保障: 早于
stacksaga.cassandra.transaction-lifetime(默认:24h)的事务会被安全隔离到es_frozen_transaction中,以防止处理陈旧事务。
参见 深度历史恢复。
Q12: 如果应用 Pod 在窗口中途中断重启且其内存中的 AtomicLong 重置为 0,是否会覆盖或损坏现有桶数据?
不会。
1. 唯一的实例身份标识: 在像 Kubernetes 这样的现代容器平台中,当容器重启或重新调度时,它会收到一个新的唯一 Pod UID / 容器标识符。
StackSaga 将该唯一的运行时标识用作 instance_id。
因此,重启后的 Pod 会写入第 5 层中完全不同的 instance_id 分区,并在第 3 层中注册为新的聚类行。
2. 聚类键隔离: 即使应用程序框架在重启后重用相同的字符串 ID,第 5 层中的数据行也是由 clustering key (transaction_id) 作为键的:
+
PRIMARY KEY ((region, cluster, service_name, date_of_year, minute_of_day, instance_id, bucket_index), transaction_id)+
具有不同 transaction_id 值的写入会追加新的聚类行,而不是覆盖现有行。
参见 有界分区:实例级本地分桶。
类别 5:运维、多租户与一致性调优 (Category 5: Operations, Multi-Tenancy, & Consistency Tuning)
Q13: 多个不同的虚拟集群是否可以在不相互干扰的情况下共享同一个 Cassandra 集群和键空间?
可以。 StackSaga 专门针对在单个统一 Cassandra 键空间上的多租户和多集群共享进行了设计。
-
复合分区键隔离: 所有 5 张目录表在其复合分区键中均包含
region、cluster和service_name(PRIMARY KEY region, cluster, service_name, …):stacksaga: instance: region: us-central cluster: us-central-cluster-1 # 单元 A -
物理环隔离: 因为 Cassandra 根据分区键的完整哈希路由数据,来自
cluster: us-central-cluster-1和cluster: us-central-cluster-2的写入和查询会落在物理上完全分离的令牌范围和 SSTable 分区中。 -
零跨集群争用: 每个虚拟集群作为一个自治单元运行,拥有自己的专用环形协调器和工作节点,零跨集群锁争用,零嘈杂邻居 (Noisy-Neighbor) 分区扫描,零数据泄露。
Q14: StackSaga 需要什么 Cassandra 一致性级别,它能否在单个 Cassandra 节点故障中存活?
StackSaga 在读取 (stacksaga.cassandra.read-consistency-level) 和写入 (stacksaga.cassandra.write-consistency-level) 中默认均使用 LOCAL_QUORUM。
-
强一致性: 在副本因子为 3 (
RF=3) 的典型 3 节点或多数据中心 Cassandra 集群中,LOCAL_QUORUM需要本地数据中心中 floor(3/2) + 1 = 2 个副本节点的确认。 -
重叠不变量: 因为 R + W = 2 + 2 = 4 > 3,这保证了强读后写一致性(读取集合与写入集合始终至少重叠一个副本节点),同时避免了到远程数据中心的高延迟广域网往返。
-
容错能力: 如果单个 Cassandra 节点发生故障或进行维护,读取和写入操作将继续不间断进行并保持完全一致性。
参见 配置属性参考。
Q15: 如果不同的编排器 Pod 或重试工作节点之间存在 NTP 时钟偏差,会发生什么?
StackSaga 对正常的时钟漂移具有弹性(通过 NTP 或 AWS Time Sync / Google NTP 同步的云 VPC 中常见的亚秒级或几秒级差异):
-
粗粒度窗口: 窗口索引以粗粒度的 1 分钟为单位运行(
minute_of_day = (hour * 60) + minute)。 微小的亚秒级漂移不会影响窗口分配。 -
前向写入缓冲: 标准节点向前写入 W+1,在窗口有资格被读取之前提供至少 60 秒的缓冲时间。
-
Node-0 门禁 2 挂钟检查: Node-0 要求当前 UTC 时间戳严格超过窗口边界后才考虑删除,从而防止因微小时间差导致的过早修剪。
-
按时间顺序恢复保证: 如果在降级的 Pod 上发生严重的时钟漂移(数分钟),它可能会稍微提前或推迟注册窗口。 但是,由于第 1 层和第 2 层均按时间顺序遍历,所有窗口最终都会被发现并恢复,不会丢失数据。
参见 三元窗口同步模型 和 Node-0 的双门禁验证协议。