Saga 设计模式介绍 (Introduction to the Saga Design Pattern)
概述 (Overview)
正如我们在 微服务架构基础页面 中所讨论的,由拥有独立数据库的服务所构建的分布式系统必然会触碰 CAP 定理的边界:要么选择具有阻塞性、基于强一致性的协调器(基于 2PC/XA 的 CP 系统),要么选择在跨网络时保持高可用并通过异步机制在稍后达成状态收敛的系统(AP 系统)。 Saga 模式正是针对该权衡中 AP 维度的具体落地架构方案。 它放弃了跨库的全局单一强一致性事务,转而将其重构为长事务 (Long-Running Transaction, LRT) —— 即由一系列较小的、各自独立提交的本地事务组成的有序链路;若链路中后续的某个步骤发生失败,则会依次触发对应的补偿事务 (Compensating Transaction) 来逆向撤销已产生的业务影响。
什么是 Saga 模式?(What is the Saga Pattern?)
Saga 模式是一种微服务架构设计模式,能够在完全不依赖传统分布式事务协调器(如 2PC/XA)的情况下,保障跨多个微服务的数据最终一致性。 一个 Saga 事务由一系列本地事务构成,每个本地事务只更新单个微服务内部的数据,并在完成时发布结果(事件或响应),以此决定链路中的下一个执行步骤。
该模式最早由 Hector Garcia-Molina 和 Kenneth Salem 在其针对数据库长时间运行事务的论文中提出,并定义了 Saga 事务的两种终态流向:
-
正向恢复 (Forward Recovery):序列中的每个分支本地事务都成功执行完毕,Saga 顺畅运行直至终点 —— 无需进行任何补偿回滚。
-
逆向恢复 (Backward Recovery):某个分支本地事务在执行途中发生业务或不可恢复异常,Saga 引擎按照严格相反的顺序,对先前所有已经提交的步骤依次执行*补偿事务 (Compensating Transactions)*,以抹平其产生的影响。
由于跨越服务边界时不存在数据库底层的原子回滚机制 —— 本地事务一旦提交,在物理上就已永久生效 —— 逆向恢复完全是通过应用层面的业务补偿调用实现的,而非物理事务层面的撤回。 为了使整套机制在无人为介入的情况下可靠运行,每一个补偿事务都必须具备幂等性 (Idempotency)与可重试性 (Retryable): 幂等性确保在网络重发或引擎重试时绝不会造成“二次扣款”或“重复补偿”;可重试性则确保瞬时的网络超时或下游短暂停机不会将 Saga 事务永久搁置在“部分补偿”的不一致危险状态。 Saga 执行协调器 (Saga Execution Coordinator, SEC) 正是负责在驱动正向推进或逆向恢复时严格保障这两项核心特性的核心引擎组件。
下图直观展示了在前文讨论的在线电商下单场景中 Saga 模式的完整运作流:

Saga 的实现形态 (Types of Saga)
Saga 模式主要有两种实现形态,它们的核心差异在于:Saga 业务流转的状态与知识到底保存在哪里? —— 是分散在所有参与服务的事件交互中,还是集中保存在单一协调器内。 这正是分布式系统设计中随处可见的永恒权衡:协同模式倾向于松耦合,而编排模式倾向于显式控制。
-
协同模式 (Choreography-based Saga / 编舞模式)
-
这是基于*事件驱动 (Event-Driven)* 的去中心化实现。每个服务执行自身的本地事务,然后发布一个领域事件来广播已发生的事实(例如
order-created、payment-processed)。 其他参与服务仅订阅它们感兴趣的事件,并在消费后执行各自的本地事务并抛出新事件 —— 整个系统中没有任何一个组件通晓全链路业务。 -
优势 (Pros):不存在单点故障或中心协调性能瓶颈;服务之间保持松耦合,增加或剔除新服务只需订阅现有事件即可,天然适应去中心化扩展。
-
劣势 (Cons):全局业务流程是隐式的 —— 它仅分散存在于各个服务的事件订阅关系中。在排查问题时,要回答“订单 #123 当前到底卡在什么状态?”极其困难,必须跨越海量事件链路进行联合追踪。随着参与者数量增长,环形事件依赖 (Cyclic Dependencies) 和重复补偿逻辑是极其常见的故障陷阱。
-
-
编排模式 (Orchestration-based Saga)
-
这是基于*指令驱动 (Command-Driven)* 的集中式实现。一个中心编排器 (Orchestrator) 将 Saga 业务流显式定义为一个状态机 (State Machine),由它按顺序依次向各个参与服务下发执行指令,并通过同步等待或异步回调确认执行结果,进而决定下一步的状态跃迁。 如果某个参与者上报失败,编排器负责统一驱动逆向恢复,按逆序向所有已执行成功的服务下发补偿指令。
-
优势 (Pros):全流程显式化且具备全局可观测性 —— Saga 当前状态、处于哪个具体步骤、历史执行快照都可以在一个中心位置直接查询,极大地简化了监控度量、异常排查以及协调器重启后的恢复恢复。
-
劣势 (Cons):编排器成为了关键路径组件;编排器本身必须具备高可用设计,且其实例状态必须持久化落盘(而不能仅保留在内存中),以防编排器进程崩溃导致正在进行中的事务丢失。
-
StackSaga 严格采用了基于编排 (Orchestration-based) 的架构模型:它将 Saga 业务工作流外置到持久化、防重启丢失的状态机存储中,确保事务执行状态绝不仅存在于单一服务的内存之中。
Saga 编排模式深度解析 (Saga Orchestration Pattern)
在运行机制层面,编排器本质上是一个有限状态机 (Finite State Machine, FSM),其状态对应于 Saga 的各个原子事务步骤,状态跃迁则由各步骤的执行结果(成功、失败、超时)驱动。
每一个 Saga 运行实例 (Instance) —— 即该工作流的一次具体执行(例如一次具体的 place-order 下单请求) —— 都绑定有一个全局唯一的关联标识符 (Correlation ID / Transaction ID),使编排器能够独立于其他并发请求对任意在途实例进行持久化、检索和断点续传。
工作流定义中的每一个步骤都严格绑定了以下四要素:
-
要调用的*参与微服务 (Participant Service)*
-
要发送的*执行指令 (Command)*
-
驱动下一步跃迁的预期*应答 (Reply)*(或超时判定)
-
当逆向恢复回滚到此步骤时所执行的*补偿指令 (Compensating Command)*
编排模式的核心优势 (Key Characteristics)
-
集中化控制 (Centralized Control):编排器逐一推进状态机跃迁,因此步骤执行顺序与逆向补偿顺序由引擎强制统一保障,无需从分散的分布式事件链路中艰难拼凑。
-
轻量级参与者 (Simplified Participants):各个微服务仅需关注如何执行好自己负责的正向指令和逆向补偿指令 —— 任何微服务都无需关心 Saga 的整体骨架或其他参与者的存在。
-
集中化异常治理 (Centralized Error Handling):超时策略、重试规则以及逆向恢复的触发逻辑全部集中在编排引擎内部,避免在各个微服务中冗余编写重复的异常防护代码。
-
持久化执行快照 (Durable Execution State):由于 Saga 实例状态实时落盘保存(而非仅仅存放在编排器堆内存中),即便编排器节点发生崩溃重启或容器漂移,也不会丢失进行中的分布式事务 —— 引擎能够从最后成功记录的状态机跃迁点精准恢复并继续执行。
最终一致性 (Eventual Consistency)
核心定义: 最终一致性保证,如果不再对特定数据项发起新的更新操作,那么所有针对该数据的后续读取最终都将返回最后一次更新的写入值。 与传统 ACID 的即时强一致性不同,它并不承诺“写操作刚刚完成后发起的读取必定立即看到该写结果” —— 它的承诺是:在没有新写入的前提下,所有节点与副本的数据会随时间流逝最终收敛 (Converge) 到一致状态。
这是 BASE 理论架构(*B*asically *A*vailable 基本可用、*S*oft state 软状态、*E*ventual consistency 最终一致性)的核心基石 —— 当 CAP 定理强制我们做出抉择 时,面向 AP 的分布式系统放弃了阻塞式强一致性,选择拥抱以可用性为首要目标的 BASE 架构。
主要特征:
-
低延迟 (Latency):写操作可以在本地步骤提交完成后立即向调用方返回 —— 数据向系统其他节点或跨服务的同步传播在后台异步完成,不会阻塞用户请求的关键链路。
-
高可用性 (Availability):即便系统中的某些物理节点或下游微服务暂时不可达,系统仍能对外正常承接请求,而绝不会无限期阻塞等待。
-
分区容忍 (Partition Tolerance):由于节点无需在对外响应前达成全局共识,系统在发生网络波动时表现为优雅降级而非整体停摆。
-
典型应用场景:广泛应用于不需要微秒级即时跨节点对齐的业务领域 —— 如 DNS 记录传播、CDN 缓存同步,以及 Cassandra、DynamoDB 等大规模 NoSQL 数据库。
生活示例: 在社交媒体平台上,用户修改头像后,该更新需要几秒钟传播到全球各地的只读副本缓存中 —— 在所有副本最终收敛之前,不同地区的好友可能会在极短的时间窗口内看到新旧不同的头像,但这绝不会破坏业务的正常运转。
Saga 模式下的最终一致性 (Eventual Consistency in Saga)
Saga 模式正是将这一思想应用于分布式业务事务的典范实践:每一个执行步骤都是一次局部的、独立提交的写操作(满足*基本可用*与*软状态* —— 在整个流程执行过程中,全局业务实体暂时处于既非原始状态、亦非最终状态的中间状态),而 Saga 引擎的核心使命就是全力驱动系统走向数据收敛。
-
异步与独立的本地步骤:由于每个原子事务独立向各自微服务的数据库提交,因此在客观物理时间线上,存在一个真实的、全局业务实体(如订单)在跨服务间处于“部分完成”的中间窗口期。
-
通过正向恢复或逆向恢复达成最终收敛:Saga 通过以下两种确定性路径之一驱动系统收敛至一致终态 —— 要么正向恢复(每一步均成功,实体达到预期最终业务状态),要么逆向恢复(某步失败,逆向补偿将实体还原至初始一致状态)。无论哪种路径,最终都会落在合法的一致状态上;最终一致性所不承诺的,仅仅是在 Saga 执行的飞逝过程中哪条路径会成为最终现实。
-
智能重试弥合瞬时抖动:针对瞬时网络抖动优先进行指数退避重试,而不是草率直接触发逆向补偿。这最大限度地保障系统沿着正向成功路径收敛,避免无谓回滚那些原本在第二次尝试时就能顺利成功的操作。
Saga 事务分类 (Classification of SAGA transactions)
根据事务的运行时行为与最终结果,在使用 Saga 设计模式时,我们主要可以识别出 3 种典型的事务执行场景:
-
完全成功事务 (Successful transactions)
-
补偿成功事务 (Compensating/Revert success transactions)
-
补偿失败事务 (Compensating/Revert failed transactions)
完全成功事务 (Primary Execution Success Transactions)

GET_USER_DETAIL 不被视为原子事务 (Atomic Transaction)。它仅是一个获取用户信息的只读查询操作。详情请参阅查询操作说明。
|
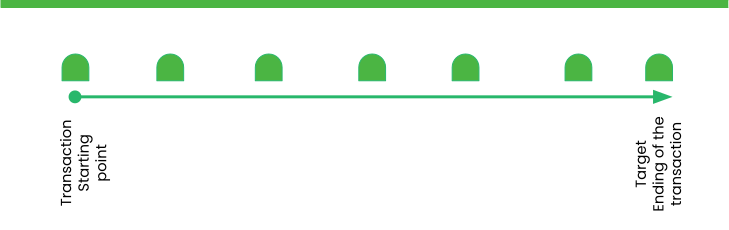
在上图中,业务流程涉及 4 个微服务并包含 4 次执行(其中 3 个为写入型原子事务)。 整个业务事务(Business Transaction)在成功执行完第 4 个原子步骤后宣告完成。 当所有正向主执行逻辑全部按预期成功执行时,这类事务被称为*完全成功事务 (Successful transactions)*。
完全成功事务的架构摘要图如下所示:
补偿成功事务 (Compensating Success Transaction)

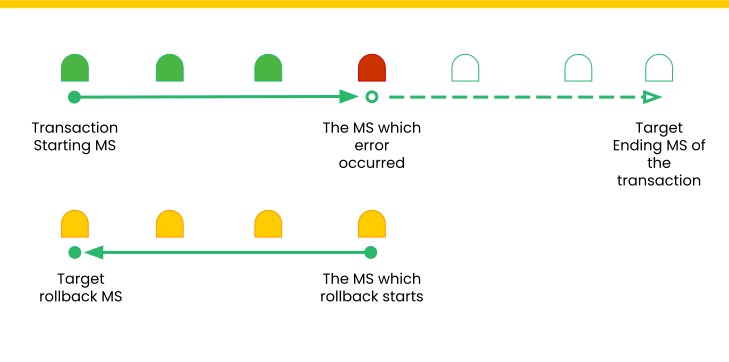
在该场景中,当执行到支付扣款步骤 (MAKE_PAYMENT) 时发生了异常。
正向主执行流程随即因错误中断,Saga 引擎立即触发逆向补偿流程,按反向顺序撤销此前所有已经成功执行的步骤。
最终,逆向补偿流程全部顺利执行完毕。
从业务视角来看,这虽然是一笔失败的业务操作;但从 Saga 架构与数据一致性的视角来看,它属于架构上的成功事务。 因为系统通过对先前已提交的局部事务进行精准补偿,成功维护了分布式环境下的最终一致性 (Eventual Consistency),没有任何脏数据残留。
补偿成功事务的架构摘要图如下所示:
补偿失败事务 (Compensating Failed Transaction)

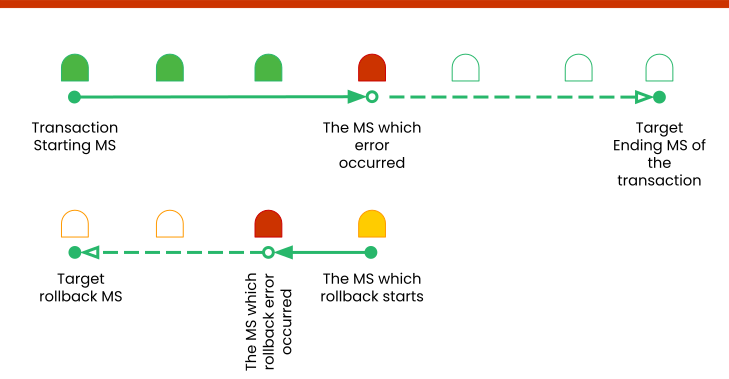
在该场景中,正向执行到支付扣款 (MAKE_PAYMENT) 时发生了异常。
正向流程终止并启动逆向补偿流程以回滚前面的操作。
然而,在执行取消订单 (CANCEL_ORDER) 的补偿逻辑时,补偿动作本身不幸发生了故障。
| 此场景代表了分布式系统中的理论边缘情况 (Edge Case)。开发者应实现健全的错误处理与防错设计,最大限度避免补偿事务本身的业务失败。 补偿事务必须严格保持幂等性 (Idempotency),且理论上仅应因瞬时基础设施故障(如资源不可用问题 / Resource Unavailability)而失败。 当遭遇下游服务暂时不可用或网络抖动时,应结合指数退避重试机制 (Exponential Backoff Retry) 与断路器 (Circuit Breakers),确保在基础设施恢复后最终达成一致性。 |
| 不必担心如何手动处理这些复杂的异常状态。 StackSaga 提供了开箱即用的重试协调机制与隔离存储,使您可以轻松管理这些异常情况。 |
补偿失败事务的架构摘要图如下所示:
使用 Saga 模式面临的技术挑战 (Challenges and Considerations of Using Saga)
-
设计复杂度 (Complexity):为每个业务步骤设计健全的正向执行、逆向补偿逻辑及其故障转移路径,相较于简单的单体本地
@Transactional注解,需要更多严谨的前期架构考量。 -
严格的幂等性要求 (Idempotency):每一个补偿事务 —— 以及所有可能被重试的正向事务 —— 都必须实现严格的 幂等性,否则重试与重发可能不仅无法修复状态,反而会导致严重的数据污染与账目差错。
-
状态持久化治理 (State Management):编排引擎必须持久化落盘存储 Saga 实例状态(绝不可仅驻留在内存中),并能在节点宕机重启后可靠地恢复在途事务,否则中途停机将导致业务事务悬挂在半途。
-
缺乏物理隔离性 (Lack of Isolation):因为各个分支本地事务执行完后立刻提交释放,所以在 Saga 执行期间,其他并发服务可能会读到未最终定稿的中间数据 —— 整个分布式 Saga 链路无法直接获得传统 ACID 的跨行跨表物理读锁隔离。
StackSaga 的编排引擎、事件溯源状态存储 (Event Store) 以及分布式重试协调代理,正是为了彻底吸收和屏蔽这些底层技术挑战而生。借助 StackSaga,各个微服务开发团队只需专注于实现自身的业务逻辑与补偿动作,底层的故障恢复与一致性保障均由框架全自动托管。
在下一节中,我们将深入探索构成 Saga 的核心微观单元 —— 原子事务 (Atomic Transactions),以及如何通过幂等性保障安全执行与重试。