Saga 分布式长事务中的故障概率与重试必要性分析 (Failure Probability and Retry Necessity)
概述 (Overview)
本文深入剖析在基于 Saga 的微服务架构中影响长事务 (Long-Running Transaction, LRT) 的各类故障模式,并阐明为什么即便在系统看似运行平稳的前提下,一套健全的异步重试子系统对于任何生产环境而言依然是一项不可妥协的刚性架构要求。
核心论点简单而深刻:
在一个治理良好的分布式系统中,针对事务发起重试的需求在统计学意义上是小概率事件 —— 但它在时间维度上却是完全不可预测的。 重试可能在任何不可预知的瞬间被触发,其诱因在爆发前往往毫无征兆,而故障恢复所需的时间窗口短则几毫秒,长则数小时。 你无法为它设定定时计划。 你无法彻底消除它。 你唯一能做的,就是从架构层面为其做好防御设计。
这绝非空洞的理论担忧。 它是分布式计算谬论 (Fallacies of Distributed Computing) 所带来的必然规律,其第一定律便明确指出:“网络是可靠的”是一个彻底的幻觉。 网络必然会丢包,连接必然会超时,下游微服务必然会在某些时刻不可达 —— 这不是因为研发团队技术粗糙,而是因为分布式系统在本质上就是由成百上千个彼此独立且互不协同的脆弱物理节点共同拼凑而成的。
业界标准的分布式故障分类如下:
-
瞬时故障 (Transient fault) —— 发生一次后随即自行恢复(例如瞬间的网络丢包或 GC 停顿)。
-
间歇性故障 (Intermittent fault) —— 不可预测地反复复发(例如网络接口抖动或交换机背板拥塞)。
-
永久性故障 (Permanent fault) —— 持续存在直至人为主动修复(例如代码配置错误、非法入参或硬件物理损坏)。
重试机制专注于解决瞬时故障与间歇性故障。
它无法自行修复永久性故障 —— 后者必须由工程师介入诊断并修复。
在 StackSaga 框架中,可重试异常 (RetryableExecutorException) 与非可重试异常 (NonRetryableExecutorException) 的划分,正是严格映射到了这一底层分类之上。
事务结果的漏斗理论模型 (The Funnel Model of Transaction Outcomes)
下图展示了在治理健全的 Saga 系统中各项事务结果的比例分布。 漏斗外形蕴含着明确的工程现实:绝大多数事务会顺畅地直接走向完全成功。 而本文重点剖析的深层故障模式则占据了漏斗最狭窄的底层 —— 虽然发生概率低,但绝非不可能发生;且每一种异常都必须由差异化的架构机制予以兜底应对。
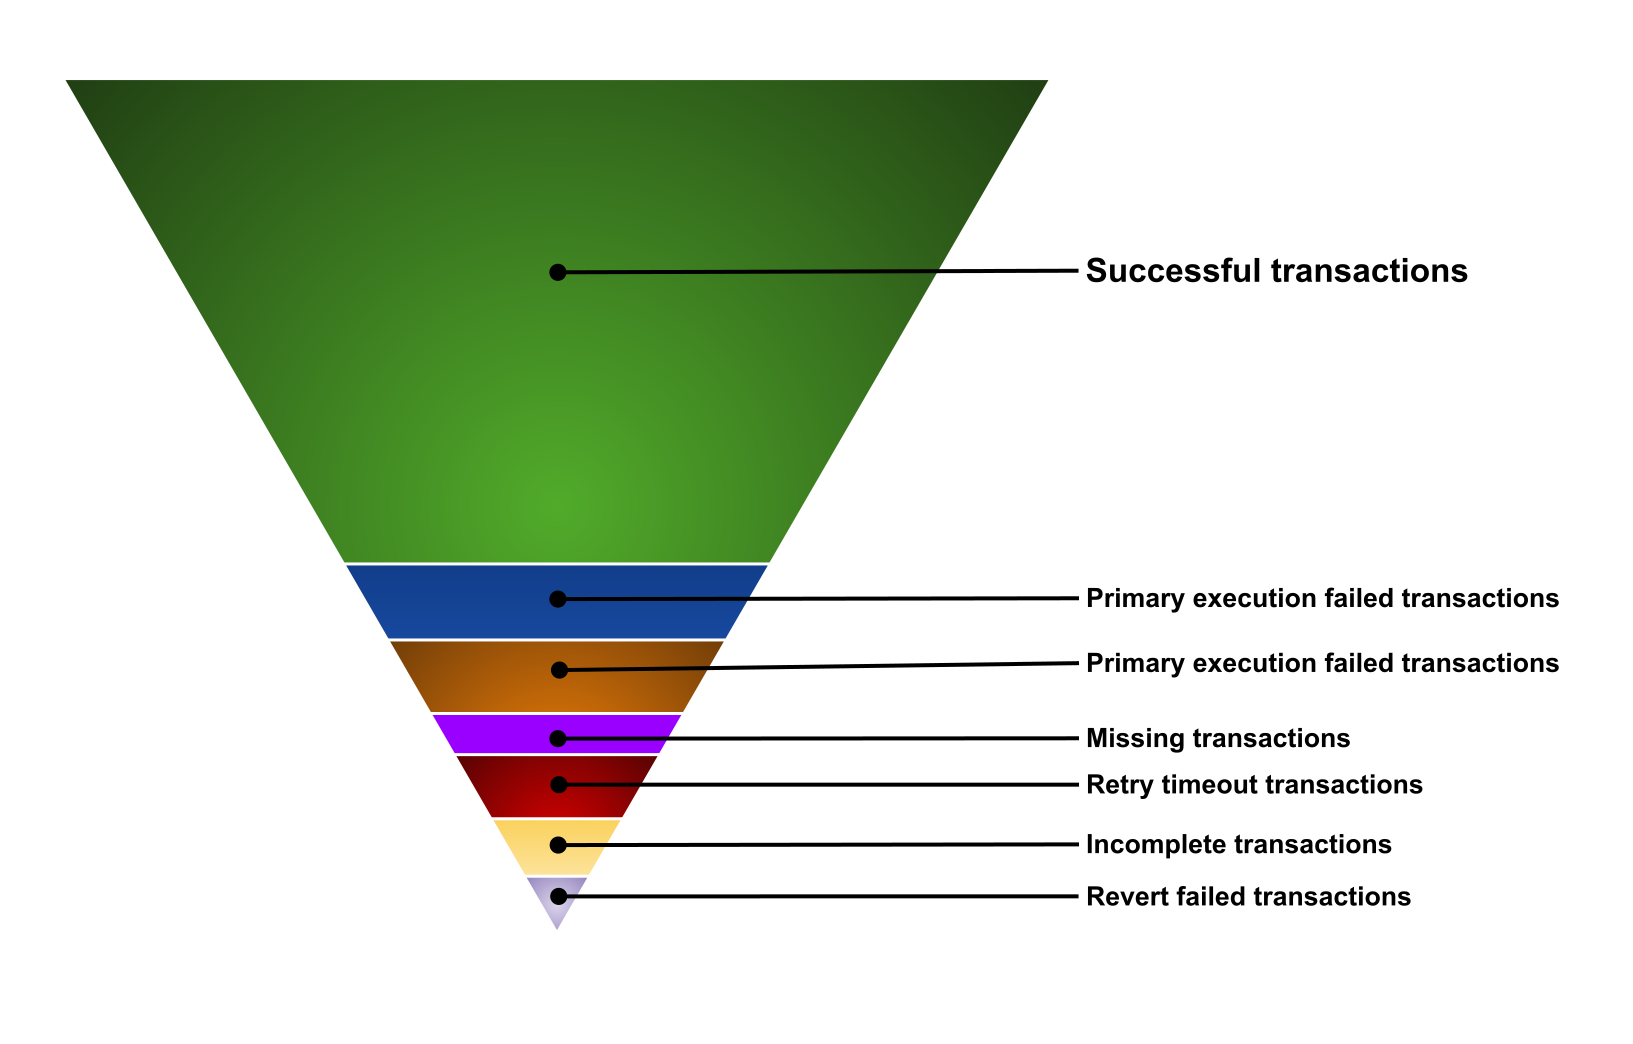
事务终态主要分为以下五大类别:
|
第 1 类和第 2 类是原生 Saga 模式能够完全覆盖并自愈的标准场景。 而第 3 类至第 5 类则是经典 Saga 模式自身所无法消除的故障深水区 —— 它们属于极其危险的架构边缘死角 (Edge Cases),必须依赖额外的基础设施才能安全闭环。 StackSaga 框架正是为了补齐这些缺失的基础设施而设计。 |
1. 完全成功事务 (Successful Transactions)
完全成功事务是任何健康分布式系统中的绝对主流终态。 每一个正向业务 Span 执行步骤均顺畅通过,事务抵达预期的最终业务状态。
此路径不需要重试子系统介入。这是系统的黄金正向通路。
2. 主正向执行失败事务(补偿成功)(Primary-Execution Failed Transactions)
部分事务在正向执行主干逻辑时,遇到了非可重试的业务逻辑错误(例如:用户账户余额不足、商品已售罄)。 这在分布式系统中不被视为系统故障 —— 它是 Saga 设计模式原本就预期会发生的分支业务流。
当非可重试错误爆发时,StackSaga 立即启动逆向补偿 (Compensation) 流程,按逆序依次撤销前面步骤已提交的工作。 一旦逆向补偿全链路顺利完成,系统即恢复到合法的一致性终态。 系统成功保障了最终一致性 (Eventual Consistency),这正是 Saga 模式的核心契约。
|
上述前两类场景完全由标准 Saga 状态机即可完整掌控。 而接下来的第 3、4、5 类场景则是标准 Saga 无法解决的难题。 尽管它们在统计上发生概率极低,但任何一次发生都将引发永久性的跨库数据不一致(脏数据残留)。 StackSaga 的核心价值之一便是彻底消除这些隐患。 |
3. 补偿执行失败事务 (Compensation Failed Transactions)
如果某个逆向补偿执行步骤因永久性(非可重试)错误发生崩溃,该事务将卡死在“部分被补偿、部分未补偿”的撕裂状态。 系统无法自动自愈 —— 往往是补偿代码逻辑本身存在 Bug 或遭遇了未预料到的脏数据。
根据前文定义,这属于典型的永久性故障 (Permanent fault)。 无休止的盲目重试对此无济于事,必须由研发人员介入诊断。
StackSaga 如何提供支撑: 即使此类事务无法全自动重试,它们也绝不会被系统遗忘或静默丢失。 StackSaga 会将其安全隔离在持久化事件存储 (Event Store) 的隔离区中,并通过管控 API 暴露给开发者。研发团队可以批量检索受损事务、定位代码缺陷、上线修复版本,随后通过恢复端点 (Restore Endpoint) 手动将其安全重新推入重试队列。 随后,引擎将从当初中断的确切 Span 步骤开始继续向后推进。
4. 进程崩溃事务 (Crashed Transactions)
在云原生微服务环境中,JVM 进程本身随时可能遭遇意外死亡 —— 无论是因为硬件故障、Kubernetes OOM 强杀、机房断电,还是宿主机 Pod 抢占驱逐。 当这一惨剧恰好在分布式事务执行正中爆发时,Saga 执行协调器 (SEC) 甚至连记录异常日志的机会都没有。 该事务便如同被物理冻结在数据库中一样,停留在最后一次持久化落盘的瞬态。
这是分布式系统中最具欺骗性的隐蔽故障,因为它对外不抛出任何报警信号。 从外部视角观察,该事务看起来就像是“仍在漫长处理中”。
具体存在两种致命场景:
-
事件存储写入途中崩溃 —— SEC 正在向事件存储持久化状态的一瞬间物理机断电。这造成了一个状态未决的边缘,无法确定事件在宕机前是否真正物理 Commit。
-
微服务业务调用中崩溃 —— 容器在执行某个业务 Span 时猝死,导致下游第三方服务处于未决的悬挂状态。
StackSaga 如何提供支撑: StackSaga 引入了事务恢复保留时间 (Transaction Restore Retention Time) 心跳防线。 每当 SEC 成功在事件存储中推进一次事务状态,都会同步刷新该记录的心跳时间戳。 如果某笔事务的时间戳超过了配置的阈值,且在此期间没有任何后续心跳推进,StackSaga 会自动将该事务判定为“宿主节点已崩溃”,并在下一个调度窗口中将其自动暴露给存活的重试节点进行接管续跑。 配置参数详情请参见*事务恢复保留时间 (Transaction Restore Retention Time)*。
5. 在途丢失事务 (Missing Transactions)
在异步重试流转过程中,事务会被派发给异步信道重新执行 —— 例如通过消息队列、HTTP 回调或异步调度引擎。 但在被真正消费处理之前,它意外消失了:消息被 Broker 丢弃、队列消息因 TTL 过期、或者接收节点在从网络拉取到消息后还未来得及执行就发生了瞬间宕机。
其结果就是一笔事务被派发了出去,却再也没有任何回音。 没有报错上报。 没有补偿触发。 该事务如同人间蒸发一般从活动处理流水线中彻底脱轨。
StackSaga 如何提供支撑: 保护系统免受节点崩溃伤害的事务恢复保留时间 (Transaction Restore Retention Time) 机制,同样完美覆盖了此类场景。 如果一笔已派发的事务在保留时间窗口内未向事件存储提交任何新的状态推进,StackSaga 会将其视为游离丢失,并自动将其重新拉回活动重试环。 整个自愈流程全自动完成,无需任何人肉运维。 配置参数详情请参见*事务恢复保留时间 (Transaction Restore Retention Time)*。
为什么重试基础设施绝不能是可选项 (Why Retry Infrastructure Cannot Be Optional)
第 3 类至第 5 类故障模式拥有一个不可抗拒的共性特征:它们无法被预知、无法被调度、也无法从物理上被完全杜绝。 无论架构师的设计多么精妙,无论硬件多么昂贵,进程崩溃、网络丢包或下游服务的短暂失联,都可能在任何一笔事务生命周期的任何微秒级瞬间发生。
这正是为什么 StackSaga 将重试子系统视为核心架构组件,而非可有可无的外挂插件。 在真正的分布式体系中,核心问题从来不是“瞬时故障*是否*会发生”,而是“它在*何时*爆发,以及会持续*多久*”。
一个只能应付理想路径(Happy Path)、却对这些现实边缘故障毫无防御策略的架构,绝不能被称为高可靠系统。 它充其量是一个“在不出事时假装运转良好,一旦出事便静默产生海量脏数据”的脆弱系统。